16/07/2026
دروس مستفادة من الذكاء الاصطناعي الصوتي في بيئات الإنتاج حول زمن الاستجابة، والتنسيق، والتكلفة، والموثوقية
وصل الذكاء الاصطناعي الصوتي إلى مرحلة لم يعد فيها بناء وكيل فعال التحدي الأكبر. فمع التقدم المحرز في التعرف على الكلام، والنماذج اللغوية، وتحويل النص إلى كلام، بات بإمكان معظم الفرق تجميع نظام يُجري محادثة طبيعية في وقت قصير نسبياً.
ولكن بمجرد انتقال هذه الأنظمة إلى مرحلة الإنتاج الفعلي، يتغير التحدي الهندسي بالكامل.
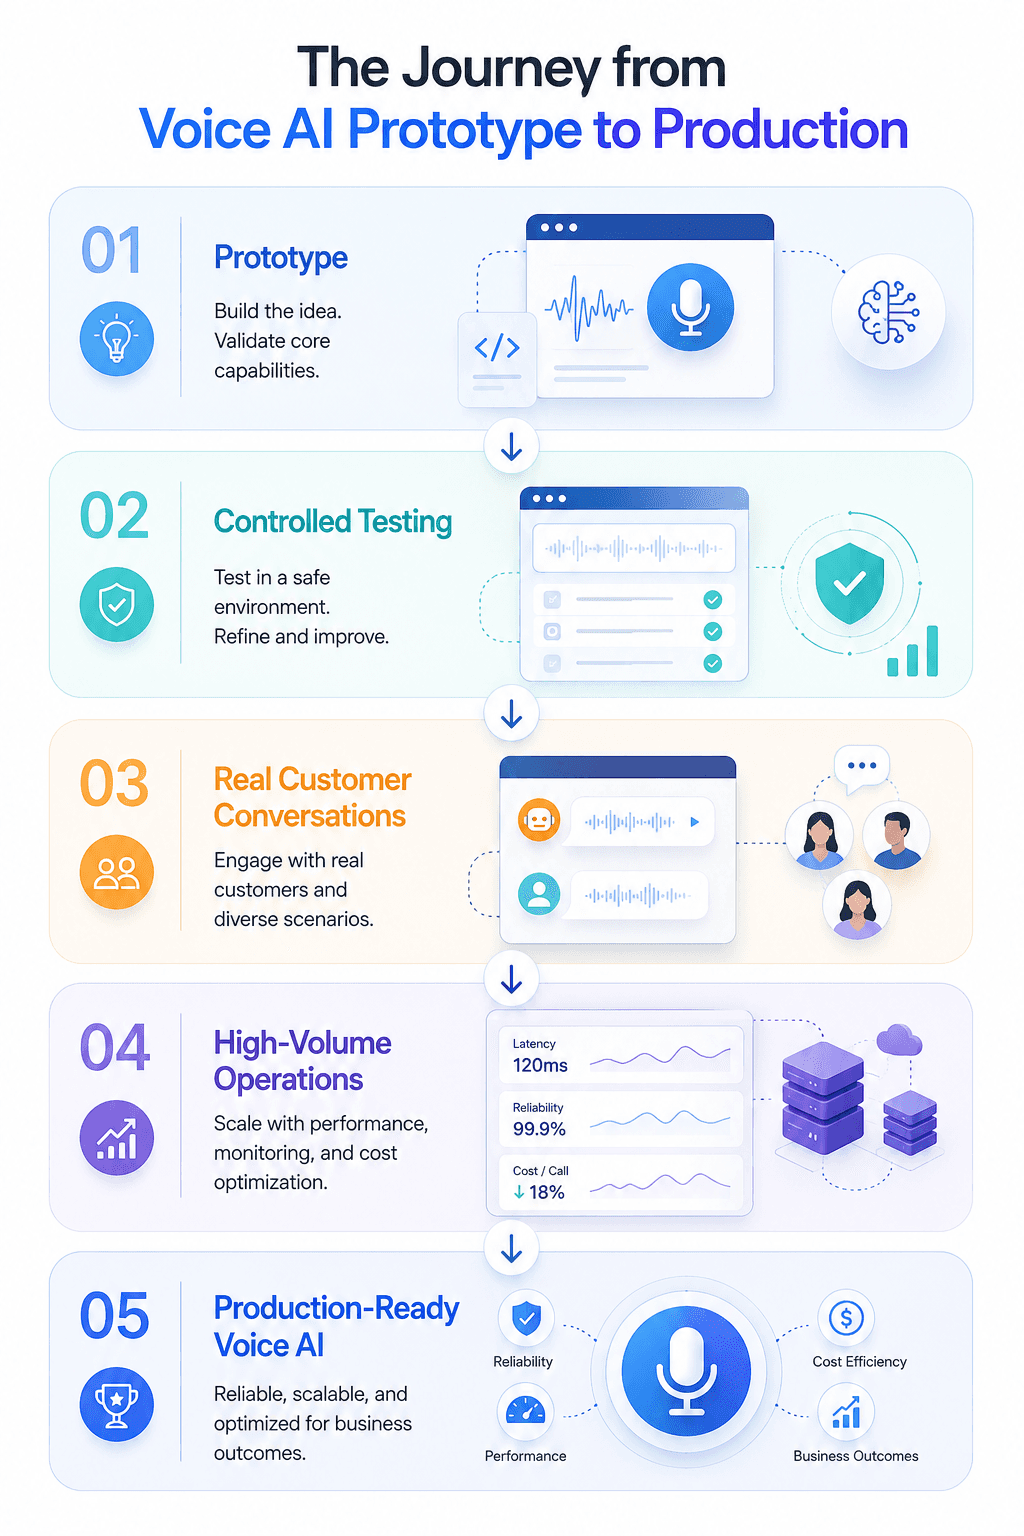
تثير عمليات النشر في بيئات الإنتاج مشكلات نادراً ما تكشفها النماذج الأولية؛ إذ تصبح المحادثات غير متوقعة، ويبدأ زمن الاستجابة في التأثير على تجربة المستخدم، وترتفع تكاليف البنية التحتية مع زيادة الاستخدام، وتتطلب خدمات متعددة العمل معاً دون الإخلال بسلاسة المكالمة. فما يبدو متناسقاً في بيئة خاضعة للرقابة يصبح أكثر تعقيداً بكثير عندما يرتبط الأمر بآلاف العملاء الحقيقيين.
تعيد هذه التحديات تشكيل الطريقة التي تتعامل بها المؤسسات مع الذكاء الاصطناعي الصوتي اليوم؛ حيث يتحول النقاش تدريجياً من بناء وكلاء أكفاء إلى بناء أنظمة تظل موثوقة، وقابلة للتكيف، ومجدية من حيث التكلفة في مرحلة الإنتاج.
في محادثة أجريت مؤخراً مع مايتريا واغ، مؤسس Bolna AI، استكشفنا العديد من هذه التحديات الهندسية من منظور الذكاء الاصطناعي الصوتي في مرحلة الإنتاج الفعلي. وتعكس تجاربه الأسئلة التي تحاول الفرق الهندسية في مختلف قطاعات الصناعة الإجابة عليها مع انتقال الذكاء الاصطناعي الصوتي إلى العمليات التجارية واسعة النطاق.
يستند هذا المقال إلى تلك الرؤى لبحث التحديات العملية الكامنة وراء توسيع نطاق الذكاء الاصطناعي الصوتي، بما في ذلك زمن الاستجابة، والتنسيق المتكامل، وتحسين التكلفة، والمراقبة، والقرارات التشغيلية المطلوبة لجعل هذه الأنظمة تعمل بموثوقية في العالم الحقيقي.
توسيع النطاق يغير طبيعة المشكلة الهندسية
تتبع معظم العروض التوضيحية للذكاء الاصطناعي الصوتي نمطاً مألوفاً؛ حيث يطرح المستخدم سؤالاً، فيفهمه النظام، ويستجيب بشكل طبيعي، وينجز المهمة في غضون ثوانٍ معدودة. وفي ظل ظروف خاضعة للرقابة، يبدو التفاعل قريباً بشكل ملحوظ من المحادثة البشرية.
ولكن بمجرد التطبيق الفعلي، تتلاشى كل هذه الافتراضات.
فالعملاء الحقيقيون يقاطعون الوكيل الصوتي أثناء حديثه، ويتوقفون في منتصف الجملة، وينتقلون بين اللغات، ويستخدمون مصطلحات غير مألوفة، ويطرحون أسئلة لم تكن متوقعة على الإطلاق أثناء مرحلة الاختبار. وفي الوقت نفسه، تتوقع الشركات من النظام أن يستجيب فوراً، ويحافظ على الدقة، ويتكامل مع سير العمل الحالي، ويواصل العمل بكفاءة مع زيادة أحجام المكالمات.
خلال نقاشنا، لخص ميتريا واغ هذا التحدي ببساطة:
"إن أكبر مشكلة نحاول حلها هي التوسع في نطاق العمل."
ويتجاوز هذا التحدي مجرد دعم المزيد من المكالمات المتزامنة؛ إذ يتعين على الذكاء الاصطناعي الصوتي في بيئة الإنتاج الفعلية حل العديد من المشكلات في وقت واحد.
الحفاظ على وقت استجابة منخفض
التعامل مع المقاطعات بشكل طبيعي
التحكم في تكاليف البنية التحتية والاستدلال
التنسيق بين خدمات متعددة دون حدوث أخطاء
قياس ما إذا كانت المحادثات تحقق بالفعل نتائج الأعمال المرجوة
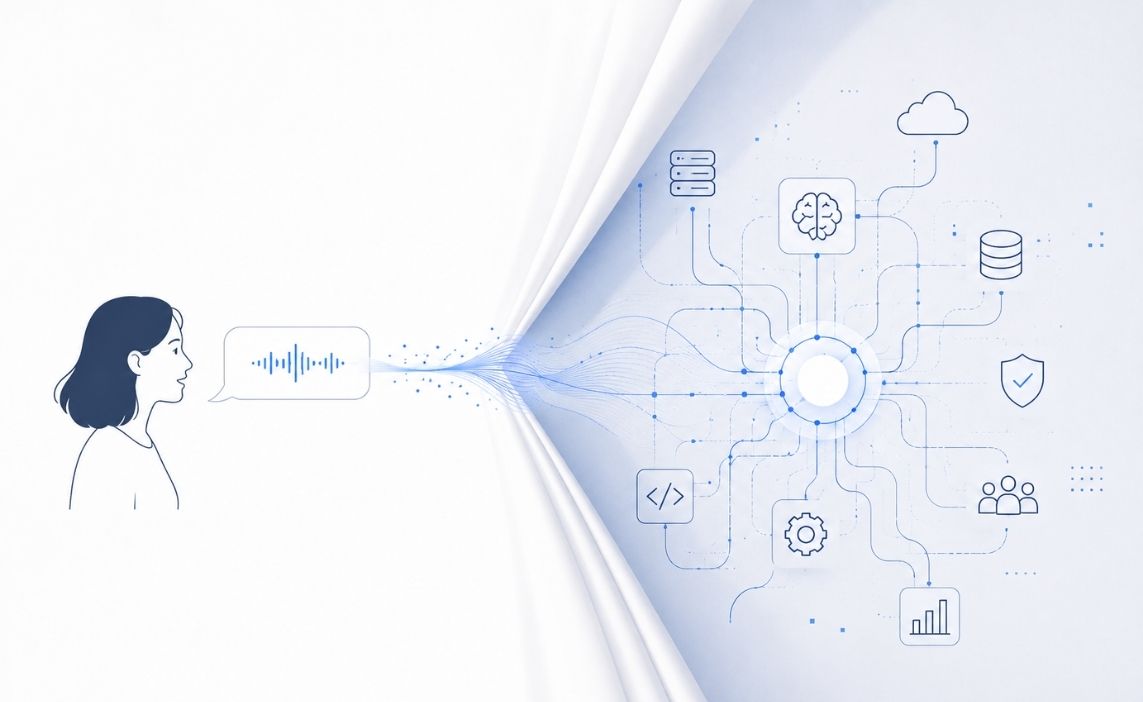
وعلى عكس برمجيات المؤسسات التقليدية، يختبر العملاء كل هذه الأنظمة كمحادثة واحدة متصلة. فهم لا يرون مطلقاً نموذج التعرف على الكلام، أو نموذج اللغة، أو منصة الاتصال الهاتفي، أو سير العمل المؤسسي الذي يعمل خلف الكواليس. وإذا تباطأ أي مكون من هذه المكونات أو تعطل، سيبدو التفاعل بأكمله غير موثوق به.
وهذا أحد الأسباب التي تجعل العمل على مستوى المؤسسات يتطلب نهجاً هندسياً مختلفاً عن روبوتات الدردشة أو أتمتة سير العمل؛ فكل عميل إضافي، وكل ثانية استجابة إضافية، وكل عملية تكامل تفرض طبقة جديدة من التعقيد التي يجب إدارتها دون التأثير سلباً على تجربة المستخدم.
ويصبح هذا النمط نفسه واضحاً في تبني الذكاء الاصطناعي في المؤسسات بشكل أوسع. ووفقاً لـ مؤشر ستانفورد للذكاء الاصطناعي 2026، فإن المؤسسات تتجاوز مرحلة التجريب بسرعة، وتضع تركيزاً أكبر على النشر والموثوقية التشغيلية ونتائج الأعمال القابلة للقياس، بدلاً من الاقتصار على قدرة النموذج وحدها.
وبالنسبة للفرق الهندسية، أصبحت النتيجة المستخلصة واضحة بصورة متزايدة؛ إذ لم يعد بناء وكيل ذكي سوى محطة واحدة في رحلة أكبر بكثير، ولم يعد زمن الاستجابة مجرد مقياس أداء، بل أصبح جزءاً لا يتجزأ من تجربة العملاء.
زمن الاستجابة هو ما يفصل بين النماذج الأولية والإنتاج الفعلي
تعمل معظم أنظمة الذكاء الاصطناعي الصوتي بشكل جيد في العروض التوضيحية المضبوطة.
يطرح العميل سؤالاً. فيستجيب النظام على الفور تقريباً. تتدفق المحادثة بشكل طبيعي، وتُنجز المهمة، ويغادر الجميع الغرفة وهم يعتقدون أن الجزء الأصعب قد انتهى.
ولكن بمجرد دخول العملاء الحقيقيين إلى المشهد، تتغير المحادثة تماماً.
فعلى عكس مستخدمي العروض التوضيحية، يقوم العملاء بالمقاطعة. ويترددون في منتصف الجملة. كما يتحدثون بلهجات مختلفة، ويغيرون الموضوعات بشكل غير متوقع، ونادراً ما يتبعون المسار الذي صُمم النظام من أجله. وتصبح المحادثة غير مرتبة لأن هذه هي الطريقة الطبيعية لتواصل البشر.
هنا يتوقف زمن الاستجابة عن كونه مجرد مقياس تقني، ويبدأ في التحول إلى مشكلة في تجربة العملاء.
نادراً ما يكون التأخير الذي يلاحظه المتصل ناتجاً عن نظام واحد. فالتفاعل الصوتي يمر عبر عدة مراحل قبل سماع الرد؛ حيث يتم تحويل الكلام إلى نص، ثم يُفسَّر الطلب، ويتم إنشاء الرد، وبعد ذلك يُعاد تحويل ذلك الرد إلى كلام منطوق قبل أن يصل أخيراً إلى المتصل عبر شبكة الاتصالات الهاتفية. لا تستغرق كل خطوة سوى جزء من الثانية، لكن هذه الأجزاء تتراكم بسرعة مدهشة.
العملاء لا يرون أي شيء من هذا يحدث. إنهم يلاحظون فقط ما إذا كانت المحادثة تبدو سلسة وتلقائية أم لا.
فإذا جاء الرد متأخراً لثانية واحدة، يبدو الأمر متردداً. وإذا بدأ النظام في التحدث بينما لا يزال العميل يتكلم، فإنه يبدو نافد الصبر. وعندما يتكرر حدوث الأمرين معاً، تتلاشى الثقة قبل وقت طويل من حصول التكنولوجيا على فرصة لإثبات كفاءتها.
وقد لخصت إحدى الملاحظات من محادثتنا هذا التحدي بشكل جيد:
"أنت بحاجة إلى ذلك النوع من البنية التي تمنحك إمكانية الوصول إلى الأفضل في تلك اللحظة بالذات لكل مكالمة من مكالماتك."
يبدو الأمر كنقاش حول النماذج، ولكنه في الحقيقة نقاش حول المرونة.
لا يمكن للأنظمة المستخدمة في بيئة العمل الفعلية أن تفترض أن أسرع محرك صوتي أو أقوى نموذج لغوي اليوم سيظل الخيار الأفضل بعد عام من الآن. كما تتطلب المحادثات المختلفة أولويات مختلفة؛ فقد يولي تفاعل دعم العملاء أهمية قصوى للسياق والدقة قبل كل شيء، في حين قد تعطي حملة الاتصالات الصادرة التي تتعامل مع آلاف المكالمات أهمية أكبر للسرعة والتكلفة التشغيلية. لذا، فإن التصميم بالاعتماد على مزود خدمة واحد أو منظومة برمجية ثابتة يترك مجالاً ضيقاً للغاية للتكيف عند تغير تلك الأولويات.
ويمثل التوقيت تحدياً آخر يصعب قياسه بدرجة أكبر بكثير.
يقاطع الناس بعضهم البعض باستمرار. نتوقف للتفكير، ونعيد بدء الجمل، ونصحح كلامنا، ونتحدث أحياناً في الوقت نفسه دون أن نلاحظ ذلك حتى. يفهم البشر هذه الإشارات بالغريزة، بينما يتعين على البرمجيات أن تتعلمها.
هل ينبغي للوكيل أن يتوقف عن الحديث لأن المتصل قاطعه؟ هل كانت تلك مقاطعة حقيقية أم مجرد توقف قصير قبل إكمال الجملة؟ إن تم الرد مبكراً جداً، ستبدو المحادثة غير طبيعية. وإن طال الانتظار أكثر من اللازم، يفقد التفاعل انسيابيته وزخمه.
وتصبح هذه القرارات أكثر صعوبة مع توسع نطاق العمليات. فقد تدعم المنصة نفسها خدمة العملاء في الصباح، وحجز المواعيد في فترة ما بعد الظهر، وعمليات التحصيل أو المبيعات بحلول المساء. لكل سير عمل توقعات مختلفة، لكن العميل يحكم عليها جميعاً باستخدام المعيار نفسه: هل بدت المحادثة طبيعية؟
لهذا السبب نادراً ما يُحل زمن الاستجابة بجعل نموذج واحد أسرع. بل يُحل من خلال تصميم نظام متكامل قادر على الاستجابة بثبات وموثوقية في ظل ظروف العالم الحقيقي. وبمجرد وصول الذكاء الاصطناعي الصوتي إلى بيئة الإنتاج الفعلي، لم تعد أجزاء الألف من الثانية مجرد قياسات هندسية، بل تصبح جزءاً أساسياً من تجربة العميل نفسها.
التنسيق هو النقطة التي يتجاوز فيها الذكاء الاصطناعي الصوتي كونه مجرد ذكاء اصطناعي
اسأل أي شخص يعمل على تطوير الذكاء الاصطناعي الصوتي عما يجعل العرض التوضيحي ناجحاً، وستكون الإجابات متشابهة في الغالب: زمن انتقال منخفض، كلام طبيعي، وجودة صوت جيدة.
لكن لا شيء من ذلك يمثل المشكلة الأكبر بمجرد وصول النظام إلى مرحلة التشغيل الفعلي والإنتاج.
إن العقبة الحقيقية الأولى أقل وضوحاً بكثير؛ وهي تسيير المحادثة عبر مسارات وأنظمة العمل دون أن تنهار.
لنأخذ إجراءً روتينياً مثل تغيير العنوان في وثيقة التأمين؛ يسمع العميل محادثة واحدة، لكن النظام لا يراها كذلك.
فقبل اكتمال الطلب، قد يحتاج النظام إلى التحقق من الهوية، واسترجاع معلومات الوثيقة، والتحقق مما إذا كان الطلب يفي بقواعد العمل، وتحديث نظام إدارة الوثائق، وتسجيل التفاعل لغايات الامتثال، وتأكيد التغيير للعميل. وتعتمد كل خطوة من هذه الخطوات على نظام مختلف.
وإذا تباطأت أي خطوة منها أو فشلت، فلن يلوم العميل نظام إدارة علاقات العملاء (CRM) أو قاعدة بيانات الوثائق، بل سيلوم المساعد الصوتي نفسه.
وخلال مناقشتنا، لخّص مايتريا واغ هذا الأمر في جملة واحدة:
"إنه مزيج من الأمرين معاً؛ فهو بمثابة توجيه المكالمات داخلياً، وتنسيق العمليات بين عدة وكلاء وعدة مسارات عمل."
غالباً ما تبدو كلمة "تنسيق العمليات" (orchestration) مصطلحاً هندسياً، لكنها في الواقع أقرب إلى التنسيق التشغيلي.
إذ لا ينبغي لمكالمة دعم العملاء أن تسلك نفس المسار الذي تسلكه مكالمة التحصيل، كما لا ينبغي لمقابلة بحثية أن تستهلك نفس الموارد التي يستهلكها الاستعلام عن الرصيد. فبعض المحادثات تتطلب استنتاجاً وتحليلاً أعمق، والبعض الآخر يحتاج إلى بيانات المؤسسة، بينما يتطلب بعضها مسار عمل مختلفاً تماماً. ويتعين على المنصة اتخاذ هذا القرار بينما لا يزال العميل يتحدث.
وهذه مشكلة مختلفة تماماً عن مجرد توليد النصوص.
وهذا أيضاً هو السبب وراء تحول بنية الذكاء الاصطناعي الصوتي بشكل متزايد لتصبح أكثر نموذجية وقابلية للتعديل (modular).
قلة قليلة جداً من فرق العمل في المؤسسات تتوقع الاحتفاظ بنفس نموذج الكلام، أو النموذج اللغوي، أو مزود خدمة الصوت لسنوات. فالنماذج الجديدة تظهر باستمرار، والتكاليف تتغير، والأداء يتحسن. وربما يؤدي قصر النظام بأكمله على مزود واحد إلى تبسيط عملية الإطلاق الأولى، لكنه يجعل كل ترقية مستقبلية أكثر صعوبة.
أما المؤسسات التي تستعد للتشغيل على المدى الطويل فتحل مشكلة مختلفة؛ إذ تبني أنظمة تتيح استبدال المكونات الفردية دون مقاطعة المحادثة أو إعادة كتابة مسار العمل بالكامل.
لقد أتاحت المشاريع مفتوحة المصدر إمكانية بناء وكلاء صوتيين أكفاء بسرعة مذهلة. ومع ذلك، فإن تشغيلهم داخل بيئة العمل لا يزال يستحوذ على معظم الجهد الهندسي؛ إذ عادة ما تصبح الموثوقية والحوكمة والتكامل وتنسيق سير العمل تحديات أكبر بكثير من المحادثة بحد ذاتها.
لهذا السبب بدأ تنسيق العمليات يكتسب أهمية تتجاوز مجرد فرق الهندسة بكثير؛ فقد أصبح قراراً معمارياً يؤثر على مدى سرعة المؤسسة في تبني التقنيات الجديدة، والتوسع في حالات استخدام جديدة، وتوسيع نطاق العمليات دون الحاجة إلى إعادة بناء كل شيء من الصفر.

التكلفة الحقيقية للذكاء الاصطناعي الصوتي ليست في النموذج
أول سؤال تطرحه معظم المؤسسات حول الذكاء الاصطناعي الصوتي هو ما إذا كان مجدياً وفعالاً.
أما السؤال الذي يليه فهو أكثر صعوبة بكثير: هل يمكن أن يواصل العمل دون أن يصبح باهظ التكلفة؟
عادةً ما يحدث هذا التحول بمجرد انتقال المشروع التجريبي إلى مرحلة الإنتاج الفعلي. فغالباً ما تبدو الاختبارات الأولية متوقعة ومستقرة؛ إذ تظل أوقات الاستجابة ثابتة، وتبقى البنية التحتية مستقرة، وتظهر تكاليف التشغيل قابلة للإدارة. ولكن الجدوى الاقتصادية الحقيقية لا تتضح إلا مع تنامي الاستخدام. فلا شيء يضع البنية الهندسية تحت الاختبار الفعلي مثل التوسع والتدرج في النطاق. فبضع مئات من المحادثات نادراً ما تكشف نقاط الضعف، بينما تكشفها آلاف المحادثات دائماً تقريباً.
وهنا أيضاً تبدأ العديد من الافتراضات في الانهيار.
خلال محادثتنا، لاحظ ميتريا واغ أن تحسين التكلفة ليس أمراً تعالجه فِرق العمل بعد بناء المساعد الصوتي، بل يتحدد من خلال القرارات الهندسية المتخذة منذ البداية.
ويصبح فهم ذلك أسهل بكثير عندما تنظر إلى ما هو أبعد من مجرد نموذج اللغة.
تمر كل محادثة بعدة طبقات قبل أن يسمع العميل أي استجابة؛ فيجب التعرف على الكلام، وتفسيره، ومعالجته، وتحويله مرة أخرى إلى صوت طبيعي، وتوصيله عبر البنية التحتية للاتصالات الهاتفية. وفي العديد من بيئات المؤسسات، يقوم النظام أيضاً باسترجاع المعلومات من قواعد البيانات الداخلية، أو تحديث السجلات، أو إطلاق مسارات عمل تجارية في الخلفية. وتضيف كل طبقة من هذه الطبقات تكلفة تشغيلية خاصة بها.
لذا، فإن النظر إلى مكون واحد بمعزل عن غيره نادراً ما يقدم الصورة الكاملة.
وينطبق الأمر ذاته على اختيار النموذج؛ فلا تتطلب كل محادثة استخدام النموذج الأكثر قدرة أو الأعلى تكلفة. فالمتصل الذي يستفسر عن حالة وثيقة تأمين لديه متطلبات تختلف تماماً عن شخص يناقش مطالبة معقدة أو يُجري عملية تحقق من الهوية. قد تؤدي معاملة كل محادثة بنفس الطريقة إلى تبسيط البنية التقنية، ولكنها تجعل عمليات النشر واسعة النطاق باهظة التكلفة دون داعٍ.
ونادراً ما تكون المفاضلة بين الجودة والتكلفة فقط؛ بل تتعلق بتحديد الحالات التي تساهم فيها القدرة العالية حقاً في تحسين تجربة العميل والحالات التي لا تضيف فيها أي فارق.
وتتعدى عملية الموازنة هذه حدود النماذج وحدها.
فقد يؤدي خفض تكاليف الاستدلال إلى كشف قيود في بنية الاتصالات الهاتفية، كما أن تحسين سرعة الاستجابة قد يزيد من معدل استخدام الموارد السحابية مع تشغيل المزيد من المحادثات في الوقت ذاته. وغالباً ما يؤدي توسيع نطاق جزء من النظام إلى نقل الضغط إلى موضع آخر، ولهذا السبب تصبح هندسة الإنتاج عملية مستمرة من التحسين بدلاً من أن تكون مهمة تُنفذ لمرة واحدة.
ويعتمد النجاح على المدى الطويل بصورة أقل على تكلفة النماذج الفردية، وبصورة أكبر على اقتصاديات المنصة بأكملها. فالعملاء لا يتعاملون مع تقنيات التعرف على الكلام، أو تحويل النص إلى كلام، أو البنية التحتية السحابية، أو واجهات برمجة التطبيقات (APIs) كتقنيات منفصلة، بل يمرون بتجربة تفاعلية واحدة، ولا تكون هذه التجربة فعالة إلا بقدر كفاءة النظام الداعم لها.
وبالنسبة للمؤسسات التي تخطط لعمليات نشر طويلة الأجل، فهذه هي الطريقة الأكثر فائدة للتفكير في الجوانب الاقتصادية. فالهدف ليس مجرد خفض تكاليف النماذج، بل بناء منصة صوتية تواصل تقديم محادثات موثوقة مع الحفاظ على استدامتها التجارية مع نمو معدلات الاستخدام والاعتماد.
الذكاء الاصطناعي الصوتي الموثوق يعتمد على النظام بأكمله، وليس النماذج وحدها
غالبًا ما يُنظر إلى اختيار نموذج الكلام أو النموذج اللغوي المناسب على أنه القرار التقني الأهم في مجال الذكاء الاصطناعي الصوتي. ولكن في الواقع، نادرًا ما تنجح الأنظمة الإنتاجية أو تفشل بناءً على نموذج واحد فحسب.
بل إنها تنجح عندما تواصل جميع الأجزاء المتحركة العمل معًا بتناغم حتى عندما تأخذ المحادثات مسارات غير متوقعة.
قد يمر تفاعل عميل واحد عبر التعرف على الكلام، والنموذج اللغوي، وتحويل النص إلى كلام، والبنية التحتية للهاتف، وخدمات المصادقة، وقواعد البيانات الداخلية، وتطبيقات الأعمال قبل إتمام المهمة بنجاح. وإذا تباطأ أي من هذه المكونات أو تعطل، فلن يدرك العميل الخدمة المحددة التي فشلت؛ بل سيشعر ببساطة بأن المحادثة لم تعد تعمل بالشكل المطلوب.
وخلال نقاشنا، أوضح مايتريا واغ أن الأنظمة الإنتاجية باتت تعتمد بشكل متزايد على عدة وكلاء ومسارات عمل تتضافر معًا، بدلاً من الاعتماد على نموذج ذكاء اصطناعي واحد يتولى كل شيء.
"العديد من العمليات التي تحدث أثناء المكالمة نفسها ليست سوى وكلاء مختلفين متصلين ببعضهم البعض."
ويعكس ذلك تحولاً أوسع نطاقاً في منهجية تصميم الأنظمة الصوتية للمؤسسات.
فبدلاً من توقع قيام نموذج ضخم واحد بإدارة كافة المهام، تلجأ المؤسسات إلى تجزئة المحادثات إلى مسؤوليات أصغر. فقد تتولى خدمة معينة التحقق من الهوية، وتعمل أخرى على استرجاع المعلومات من أنظمة المؤسسة، بينما تدير خدمة ثالثة سياق المحادثة نفسه. هذا النهج يسهّل صيانة النظام، ولكنه يفرض في الوقت ذاته تحديًا جديدًا؛ إذ تصبح كل تبعية إضافية نقطة فشل محتملة أخرى إذا لم تُصمم البنية التحتية الشاملة بعناية فائقة.
وينطبق التفكير نفسه على نماذج الذكاء الاصطناعي الأساسية.
فالذكاء الاصطناعي الصوتي يتطور بوتيرة أسرع من أن تسمح للمؤسسات بافتراض أن المزود المفضل اليوم سيظل الخيار الأفضل طوال فترة تشغيل النظام. إذ تستمر نماذج الكلام الأفضل، والنماذج اللغوية الأسرع، وأنظمة التوليف الصوتي المحسنة في الظهور تباعًا. وقد يؤدي بناء النظام بالاعتماد على مزود واحد إلى تبسيط عملية النشر الأولى، إلا أنه غالبًا ما يزيد من صعوبة إجراء التحسينات المستقبلية.
وكما قال مايتريا:
"أنت بحاجة إلى طبقة تمنحك إمكانية الوصول إلى الأفضل في تلك اللحظة بالذات لكل مكالمة من مكالماتك."
وقد أصبحت هذه المرونة ركيزة أساسية في البنية التحتية للأنظمة الإنتاجية؛ فهي تتيح للمؤسسات ترقية أجزاء محددة من النظام دون الحاجة إلى إعادة بناء التطبيق بالكامل في كل مرة تتغير فيها معالم التكنولوجيا.
وبالنسبة لفرق العمل في المؤسسات، لم تعد الموثوقية تُقاس بجودة النموذج فحسب، بل باتت تعتمد على قدرة النظام المتكامل على مواصلة تقديم محادثات متسقة مع تطور متطلبات الأعمال، وتوقعات العملاء، وقدرات الذكاء الاصطناعي. إن أقوى الأنظمة الإنتاجية هي تلك المصممة لاستيعاب التغيير والتكيف معه بدلاً من مقاومته.
المراقبة هي التي تحدد ما إذا كان الذكاء الاصطناعي الصوتي يقدم قيمة حقيقية بالفعل
يُعد بناء نظام ذكاء اصطناعي صوتي قادر على الرد على المكالمات أمراً بسيطاً نسبياً مقارنةً بفهم ما إذا كانت تلك المحادثات ناجحة بالفعل.
بمجرد دخول الذكاء الاصطناعي الصوتي مرحلة التشغيل الفعلي، تحتاج المؤسسات إلى إجابات تتجاوز مجرد وقت التشغيل وسرعة الاستجابة. هل أنجز العملاء المهمة التي اتصلوا من أجلها؟ أين تعثرت المحادثات؟ في أي مرحلة قاطع العملاء المساعد الآلي، أو طلبوا التحدث إلى موظف بشري، أو أنهوا المكالمة كلياً؟ دون هذه الإجابات، يصبح تحسين النظام مجرد ضرب من التخمين إلى حد كبير.
خلال نقاشنا، أكد ميتريا واغ أن المراقبة هي أحد المجالات التي تستحق مزيداً من الاهتمام مع نضوج مشاريع نشر الذكاء الاصطناعي الصوتي.
"علينا التركيز بشكل مكثف جداً على المراقبة والتقييم."
يكمن التحدي في أن مراقبة نظام الذكاء الاصطناعي الصوتي تختلف اختلافاً جوهرياً عن مراقبة البرمجيات التقليدية. تظل مقاييس البنية التحتية مهمة، لكنها لا تكشف سوى جزء من الحقيقة؛ فقد يتمتع النظام بزمن انتقال منخفض، واستقرار في التشغيل، ودقة في التعرف على الكلام، ومع ذلك يقدم نتائج سيئة للعملاء إذا فشلت المحادثات في الوصول إلى حل مجدٍ.
بالنسبة لبيئات العمل الفعلية، يجب قياس الأداء التقني وأداء الأعمال جنباً إلى جنب. قد تتابع الفرق الهندسية سرعة الاستجابة، أو معدلات المقاطعة، أو دقة التعرف على الكلام، أو مكالمات واجهة برمجة التطبيقات (API) الفاشلة. في المقابل، تركز فرق العمل بشكل أكبر على إتمام المهام، أو حل المشكلة من أول مكالمة، أو رضا العملاء، أو الامتثال، أو معدلات التحويل. والاطلاع على جانب واحد فقط يعطي صورة غير مكتملة عن أداء النظام.
ينعكس هذا النهج الأشمل في إطار إدارة مخاطر الذكاء الاصطناعي الصادر عن المعهد الوطني للمعايير والتكنولوجيا (NIST)، والذي يحث المؤسسات على مراقبة أنظمة الذكاء الاصطناعي باستمرار ضمن سياق استخدامها الفعلي بدلاً من الاعتماد فقط على الأداء التقني. وبالنسبة للذكاء الاصطناعي الصوتي في المؤسسات، يعني ذلك تقييم ما إذا كان النظام يحقق باستمرار النتائج المصمم من أجلها مع الحفاظ على كفاءته مع تطور سلوك العملاء ومتطلبات الأعمال.
من الاعتبارات المهمة الأخرى أنه لا توجد مؤسستان تُعرّفان النجاح بنفس الطريقة تماماً. فقد يقيس أحد البنوك مدى إتمام التحقق من الهوية بشكل آمن، بينما تركز شركة التأمين على تسوية المطالبات والامتثال، في حين تهتم مؤسسة الرعاية الصحية بحجز المواعيد وتجربة المرضى. قد تكون التكنولوجيا المستخدمة متشابهة، لكن معايير النجاح تتحدد وفقاً لأهداف العمل.
مع تحول الذكاء الاصطناعي الصوتي إلى جزء من العمليات اليومية، لم تعد المراقبة مجرد مهمة تشغيلية عادية، بل أصبحت حلقة التقييم الراجعة التي تحدد مواضع تحسين الأنظمة، والمواضع التي تتطلب إعادة تصميم لسير العمل، وحيث لا يزال التدخل البشري ضرورياً. وستكون المؤسسات التي تستثمر في التقييم المستمر في وضع أفضل لتطوير أنظمة الذكاء الاصطناعي الصوتي لديها بمرور الوقت، بدلاً من الاعتماد على افتراضات وُضعت أثناء مرحلة الإطلاق الأولية.
الذكاء الاصطناعي الصوتي يدخل مرحلة التخصص
تتطور معظم أسواق التكنولوجيا بطرق متشابهة. فخلال السنوات الأولى، غالباً ما تحاول الشركات بناء كل طبقة من طبقات الحزمة البرمجية بأنفسها. ومع نضوج السوق، تصبح تلك الأدوار أكثر تخصصاً؛ حيث تركز بعض المؤسسات على البنية التحتية الأساسية، بينما تبني أخرى المنصات، في حين تتولى غيرها حل مشكلات أعمال محددة استناداً إلى تلك الأسس.
ويبدو أن الذكاء الاصطناعي الصوتي يسلك مساراً مماثلاً.
خلال محادثتنا، لخص مايتريا واغ هذا التحول بملاحظة بسيطة:
"الجميع يفعل كل شيء في الوقت الحالي، ولكن قريباً ستبدأ الشركات في اكتشاف ما تتقنه بشكل أفضل."
وقد بدأ هذا التغيير في التبلور بالفعل. فبدلاً من بناء تقنيات التعرف على الكلام، والنماذج اللغوية، والتنسيق، والبنية التحتية للاتصالات، وتطبيقات المؤسسات تحت سقف واحد، بدأت العديد من المؤسسات في التركيز على المجالات التي يمكنها من خلالها تقديم أكبر قدر من القيمة. والنتيجة هي منظومة أوسع تعمل فيها التقنيات المتخصصة معاً بدلاً من التنافس للقيام بكل شيء.
وبالنسبة لمشتري المؤسسات، يغير هذا الطريقة التي ينبغي بها تقييم الذكاء الاصطناعي الصوتي. فأصبح اختيار المنصة لا يقتصر على العثور على مزود واحد يقدم كل الإمكانات، بل بات يتعلق باختيار التقنيات التي تتكامل بشكل جيد، وتظل مرنة، ويمكنها التطور مع تغير احتياجات الأعمال. وأصبحت القدرة على استبدال جزء واحد من الحزمة البرمجية أو ترقيته دون إعادة بناء النظام بالكامل ميزة عملية وليست مجرد تفضيل تقني.
كما أشارت المحادثة إلى تحول آخر؛ فرغم أن الكثير من الاهتمام ينصب اليوم على خدمة العملاء ذات الحجم الكبير والمكالمات الصادرة، إلا أن بعض الفرص الأكثر قيمة قد تكمن في مجالات أخرى. فالمقابلات البحثية، والاستشارات المالية، واستشارات التأمين، والمحادثات في مجال الرعاية الصحية تتطلب أنظمة يمكنها الحفاظ على سياق المحادثة، والتحليل المنطقي عبر المناقشات الطويلة، ودعم التفاعلات الأكثر عمقاً. وتتطلب حالات الاستخدام هذه مستوى مختلفاً من النضج مقارنة بمجرد الإجابة على استفسارات العملاء الروتينية.
ومع استمرار تطور الذكاء الاصطناعي الصوتي، فإن المؤسسات التي تصنع قيمة طويلة الأجل قد لا تكون هي تلك التي تحاول بناء كل طبقة بنفسها، بل يُرجح أن تكون هي التي تفهم المجالات التي يمكنها تقديم أكبر مساهمة فيها وتبني أنظمة موثوقة تستند إلى تلك الخبرة.
من النماذج التوضيحية إلى أنظمة يمكن الاعتماد عليها
لقد تجاوز الذكاء الاصطناعي الصوتي مرحلة إثبات قدرة الآلات على إجراء محادثات طبيعية. ويكمن التحدي الأكبر اليوم في جعل تلك المحادثات موثوقة بدرجة كافية تجعل الشركات تعتمد عليها في عملياتها اليومية بثقة.
إن الدروس المستفادة من هذا النقاش تعكس تحولاً أوسع نطاقاً يشهده هذا المجال. فبناء وكيل صوتي قادر ليس سوى جزء واحد من الرحلة، بينما تبدأ المهمة الأصعب عندما تحتاج المؤسسات إلى أن يؤدي هذا النظام عمله بكفاءة متسقة عبر آلاف المحادثات الحقيقية، مع تحقيق التوازن بين زمن الاستجابة، والتكلفة التشغيلية، والموثوقية، والحوكمة، والنتائج الملموسة للأعمال.
ولا يمكن حل هذه التحديات بمجرد الاعتماد على نماذج أفضل فحسب، بل تتطلب هندسة دقيقة، وتصميماً مدروساً للأنظمة، وتقييماً مستمراً بعد النشر الفعلي. ومع تحول الذكاء الاصطناعي الصوتي إلى جزء أساسي من العمليات التجارية الجوهرية، فإن النجاح سيعتمد بشكل متزايد على جودة بيئة الإنتاج المحيطة بالنماذج بدلاً من النماذج ذاتها.
وقد قدمت المحادثة مع مايتريا واغ رؤية واحدة لهذه التحديات الإنتاجية، إلا أن الدروس المستفادة تتجاوز حدود شركة بعينها؛ إذ إنها تعكس التساؤلات التي تسعى فِرق الهندسة وقادة المنتجات وصناع القرار في المؤسسات عبر مختلف القطاعات إلى الإجابة عنها الآن.
في SubVerse AI، نواصل استكشاف هذه المحادثات مع المؤسسين والمهندسين وقادة التكنولوجيا الذين يبنون أنظمة ذكاء اصطناعي للنشر في بيئات العمل الواقعية. وإذا كنت مهتماً باكتساب رؤى عملية حول الذكاء الاصطناعي للمؤسسات وهندسة بيئات الإنتاج، فتابع InsurTech Insiders: The Insurance AI Community لمزيد من النقاشات والتحليلات والدروس المستفادة من الفِرق التي تتصدى لهذه التحديات على نطاق واسع.
جدول المحتويات
المزيد من الرؤى والأفكار