21/05/2026
قطعت تقنية الذكاء الاصطناعي الصوتي شوطاً طويلاً مقارنة بتلك الأنظمة الآلية الجامدة التي كانت تبدو وكأنها تقرأ نماذج ضريبية بصوت عالٍ. واليوم، تبدو أفضل وكلاء الصوت المدعومة بالذكاء الاصطناعي قادرة على إجراء محادثات تفاعلية، ومدركة للمشاعر، وقريبة بشكل مدهش من الصوت البشري في بعض الأحيان.
إذن، ما الذي يدفع هذا التحول؟
إنه جيل جديد من نماذج تحويل الكلام إلى كلام (S2S) في الوقت الفعلي، والتي تُحدث تحولاً جذرياً في طريقة بناء الشركات الناشئة في مجال الذكاء الاصطناعي الصوتي لوكلاء صوتيين سريعين وطبيعيين وأذكياء.
دعونا نلقي نظرة تفصيلية على التكنولوجيا، وسحرها، والحقائق المعقدة الكامنة وراء هذه الأنظمة التفاعلية الحديثة.
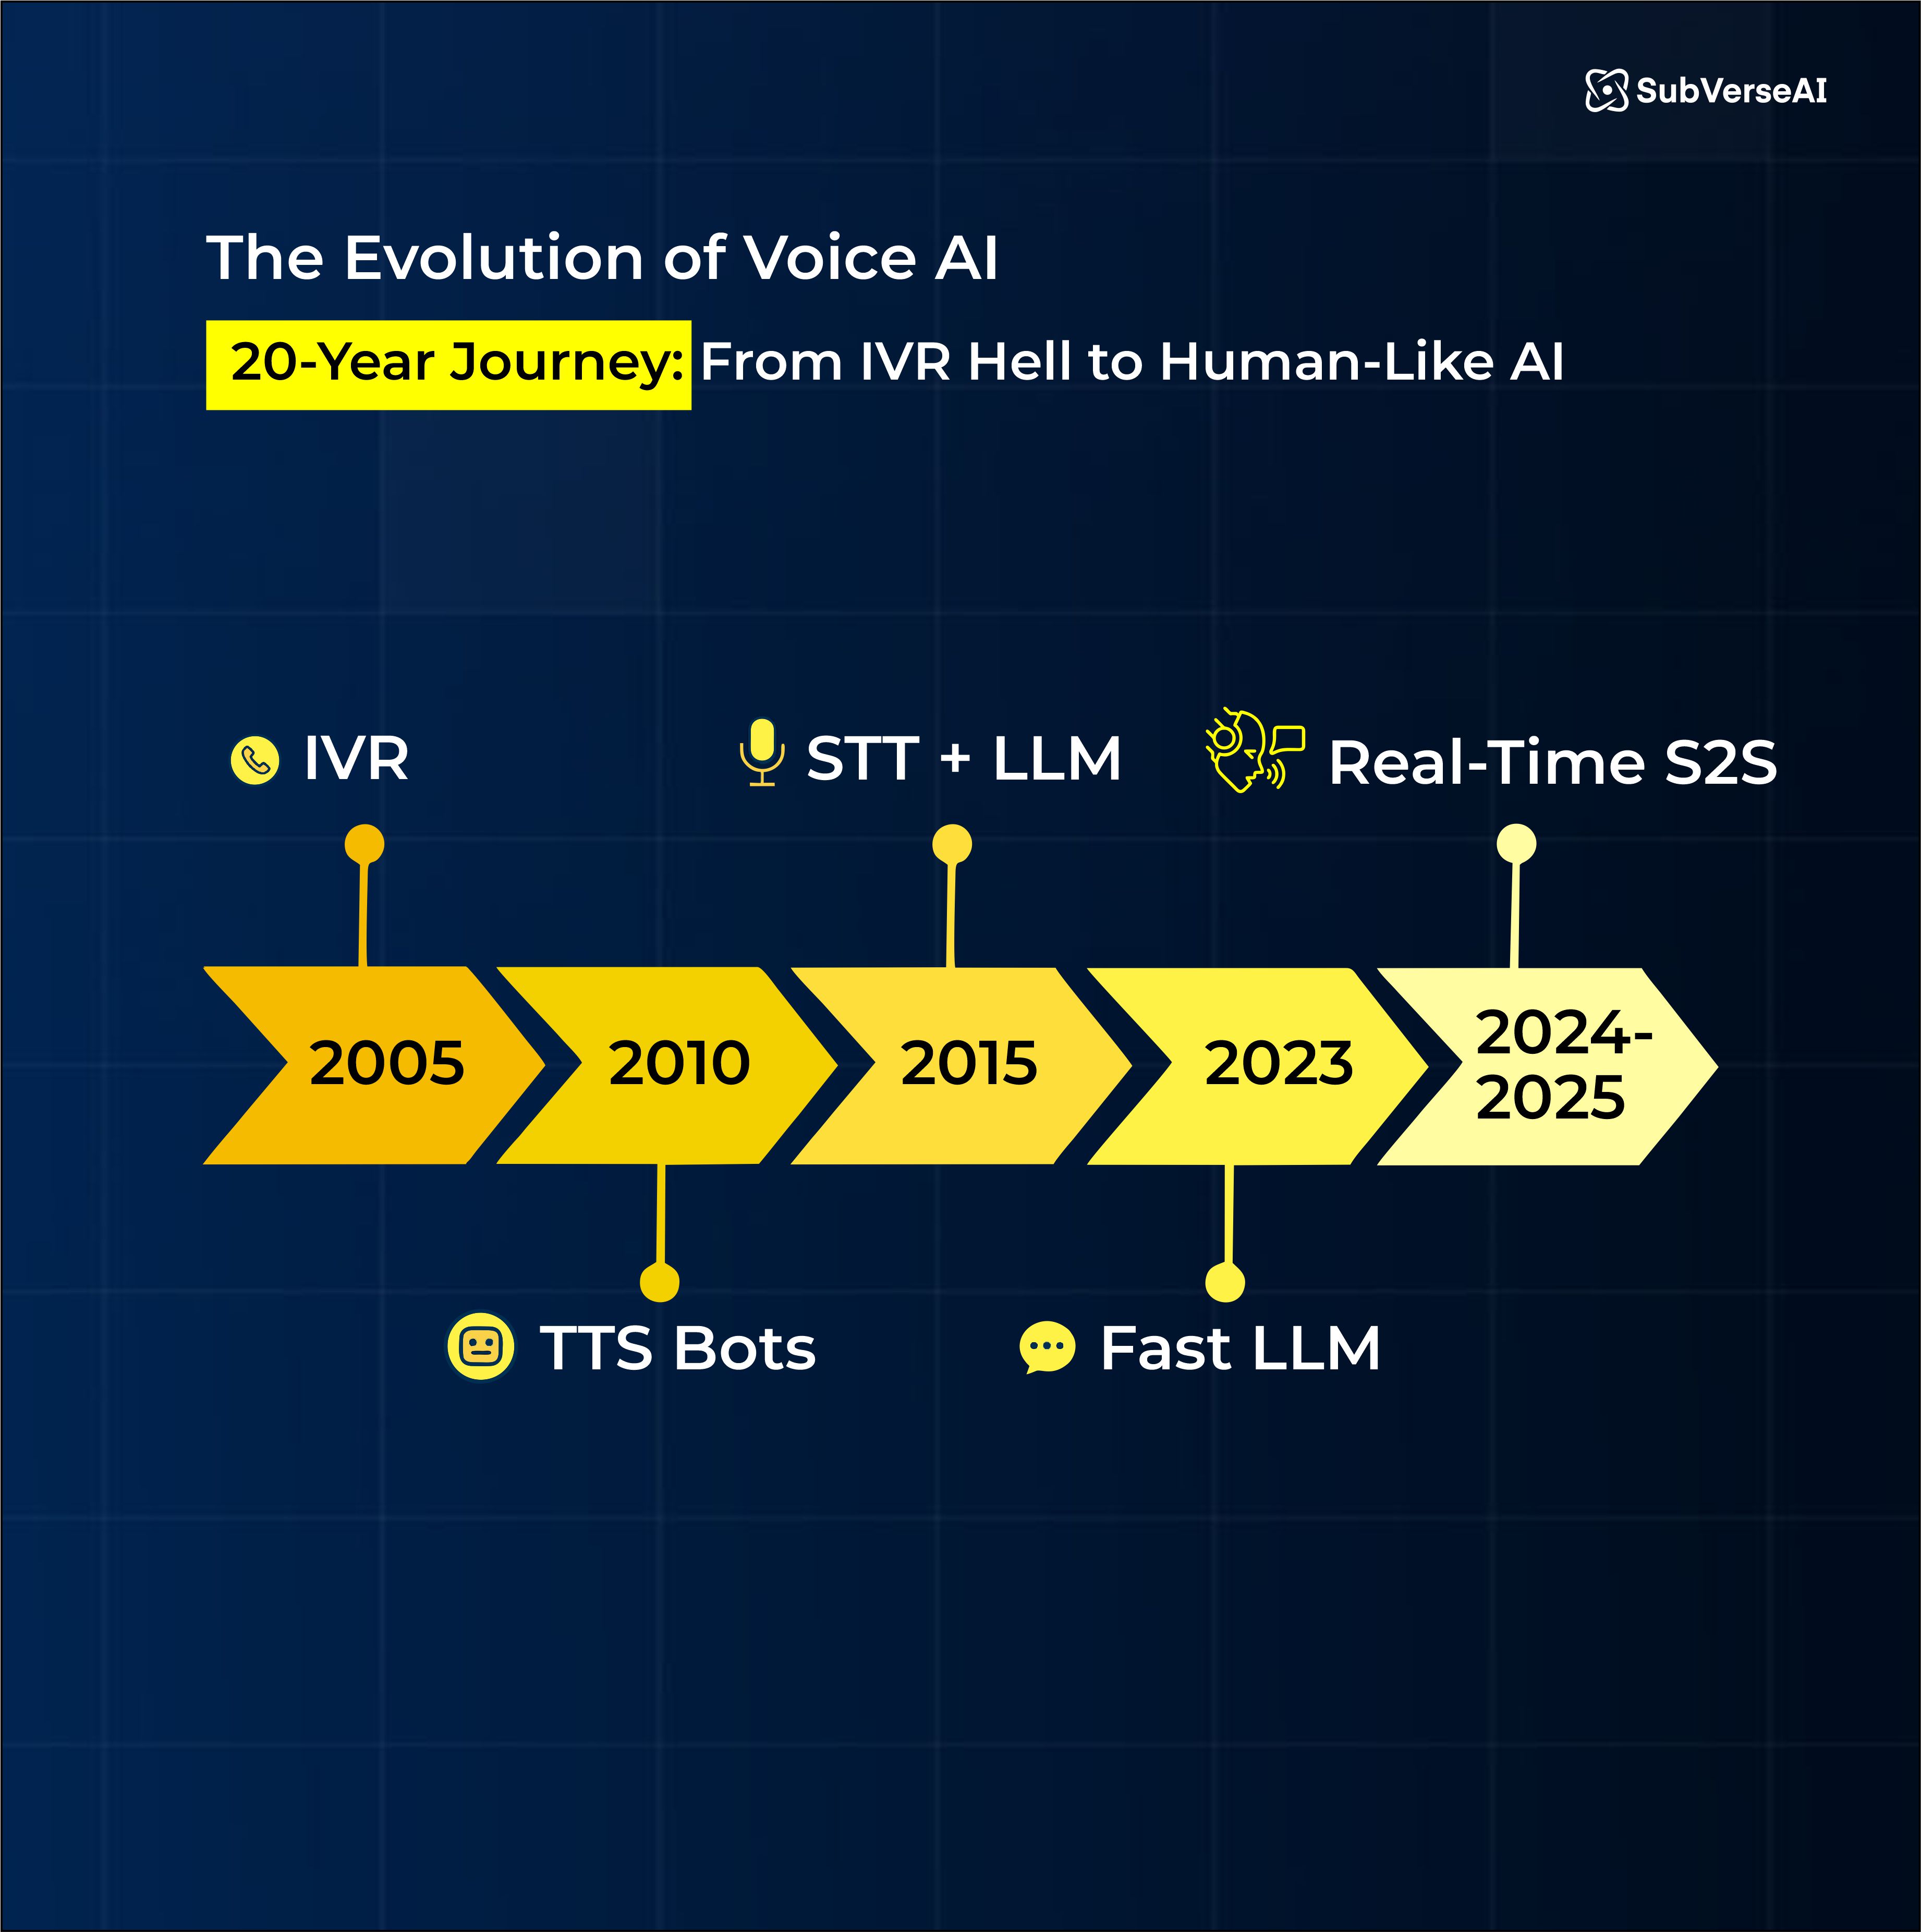
من خطوط المعالجة المعقدة إلى البث المباشر في الوقت الفعلي
في اللحظة التي تقول فيها "مرحباً!" للوكيل الصوتي، تبدأ المعالجة. لكن لا تتعامل كافة الأنظمة مع تلك اللحظة بالطريقة ذاتها.
العالم القديم: مسار المعالجة المكوّن من 3 خطوات
كانت معظم مسارات الذكاء الاصطناعي الصوتي التقليدية تبدو هكذا:
تحويل الكلام إلى نص (STT)
معالجة بالنماذج اللغوية الكبيرة / فهم اللغة الطبيعية (LLM / NLU)
تحويل النص إلى كلام (TTS)
فعّال وموثوق، لكنه بطيء. كانت كل خطوة تمثل نقطة اختناق خاصة بها، مما حوّل العملية برمتها إلى سباق تتابع مع عدائين متواضعي الأداء.
العالم الجديد: من كلام إلى كلام في الوقت الفعلي (S2S)
تتخطى نماذج S2S في الوقت الفعلي من منصات مثل OpenAI Realtime وGoogle Gemini Live هذا التتابع البطيء وتتعامل مع الصوت كتدفق مستمر. وأثناء حديثك:
يتم تحويل جزء من صوتك إلى نص
يبدأ النموذج في التحليل والاستنتاج فوراً
يتم إنشاء الرد - حتى قبل أن تنتهي من كلامك
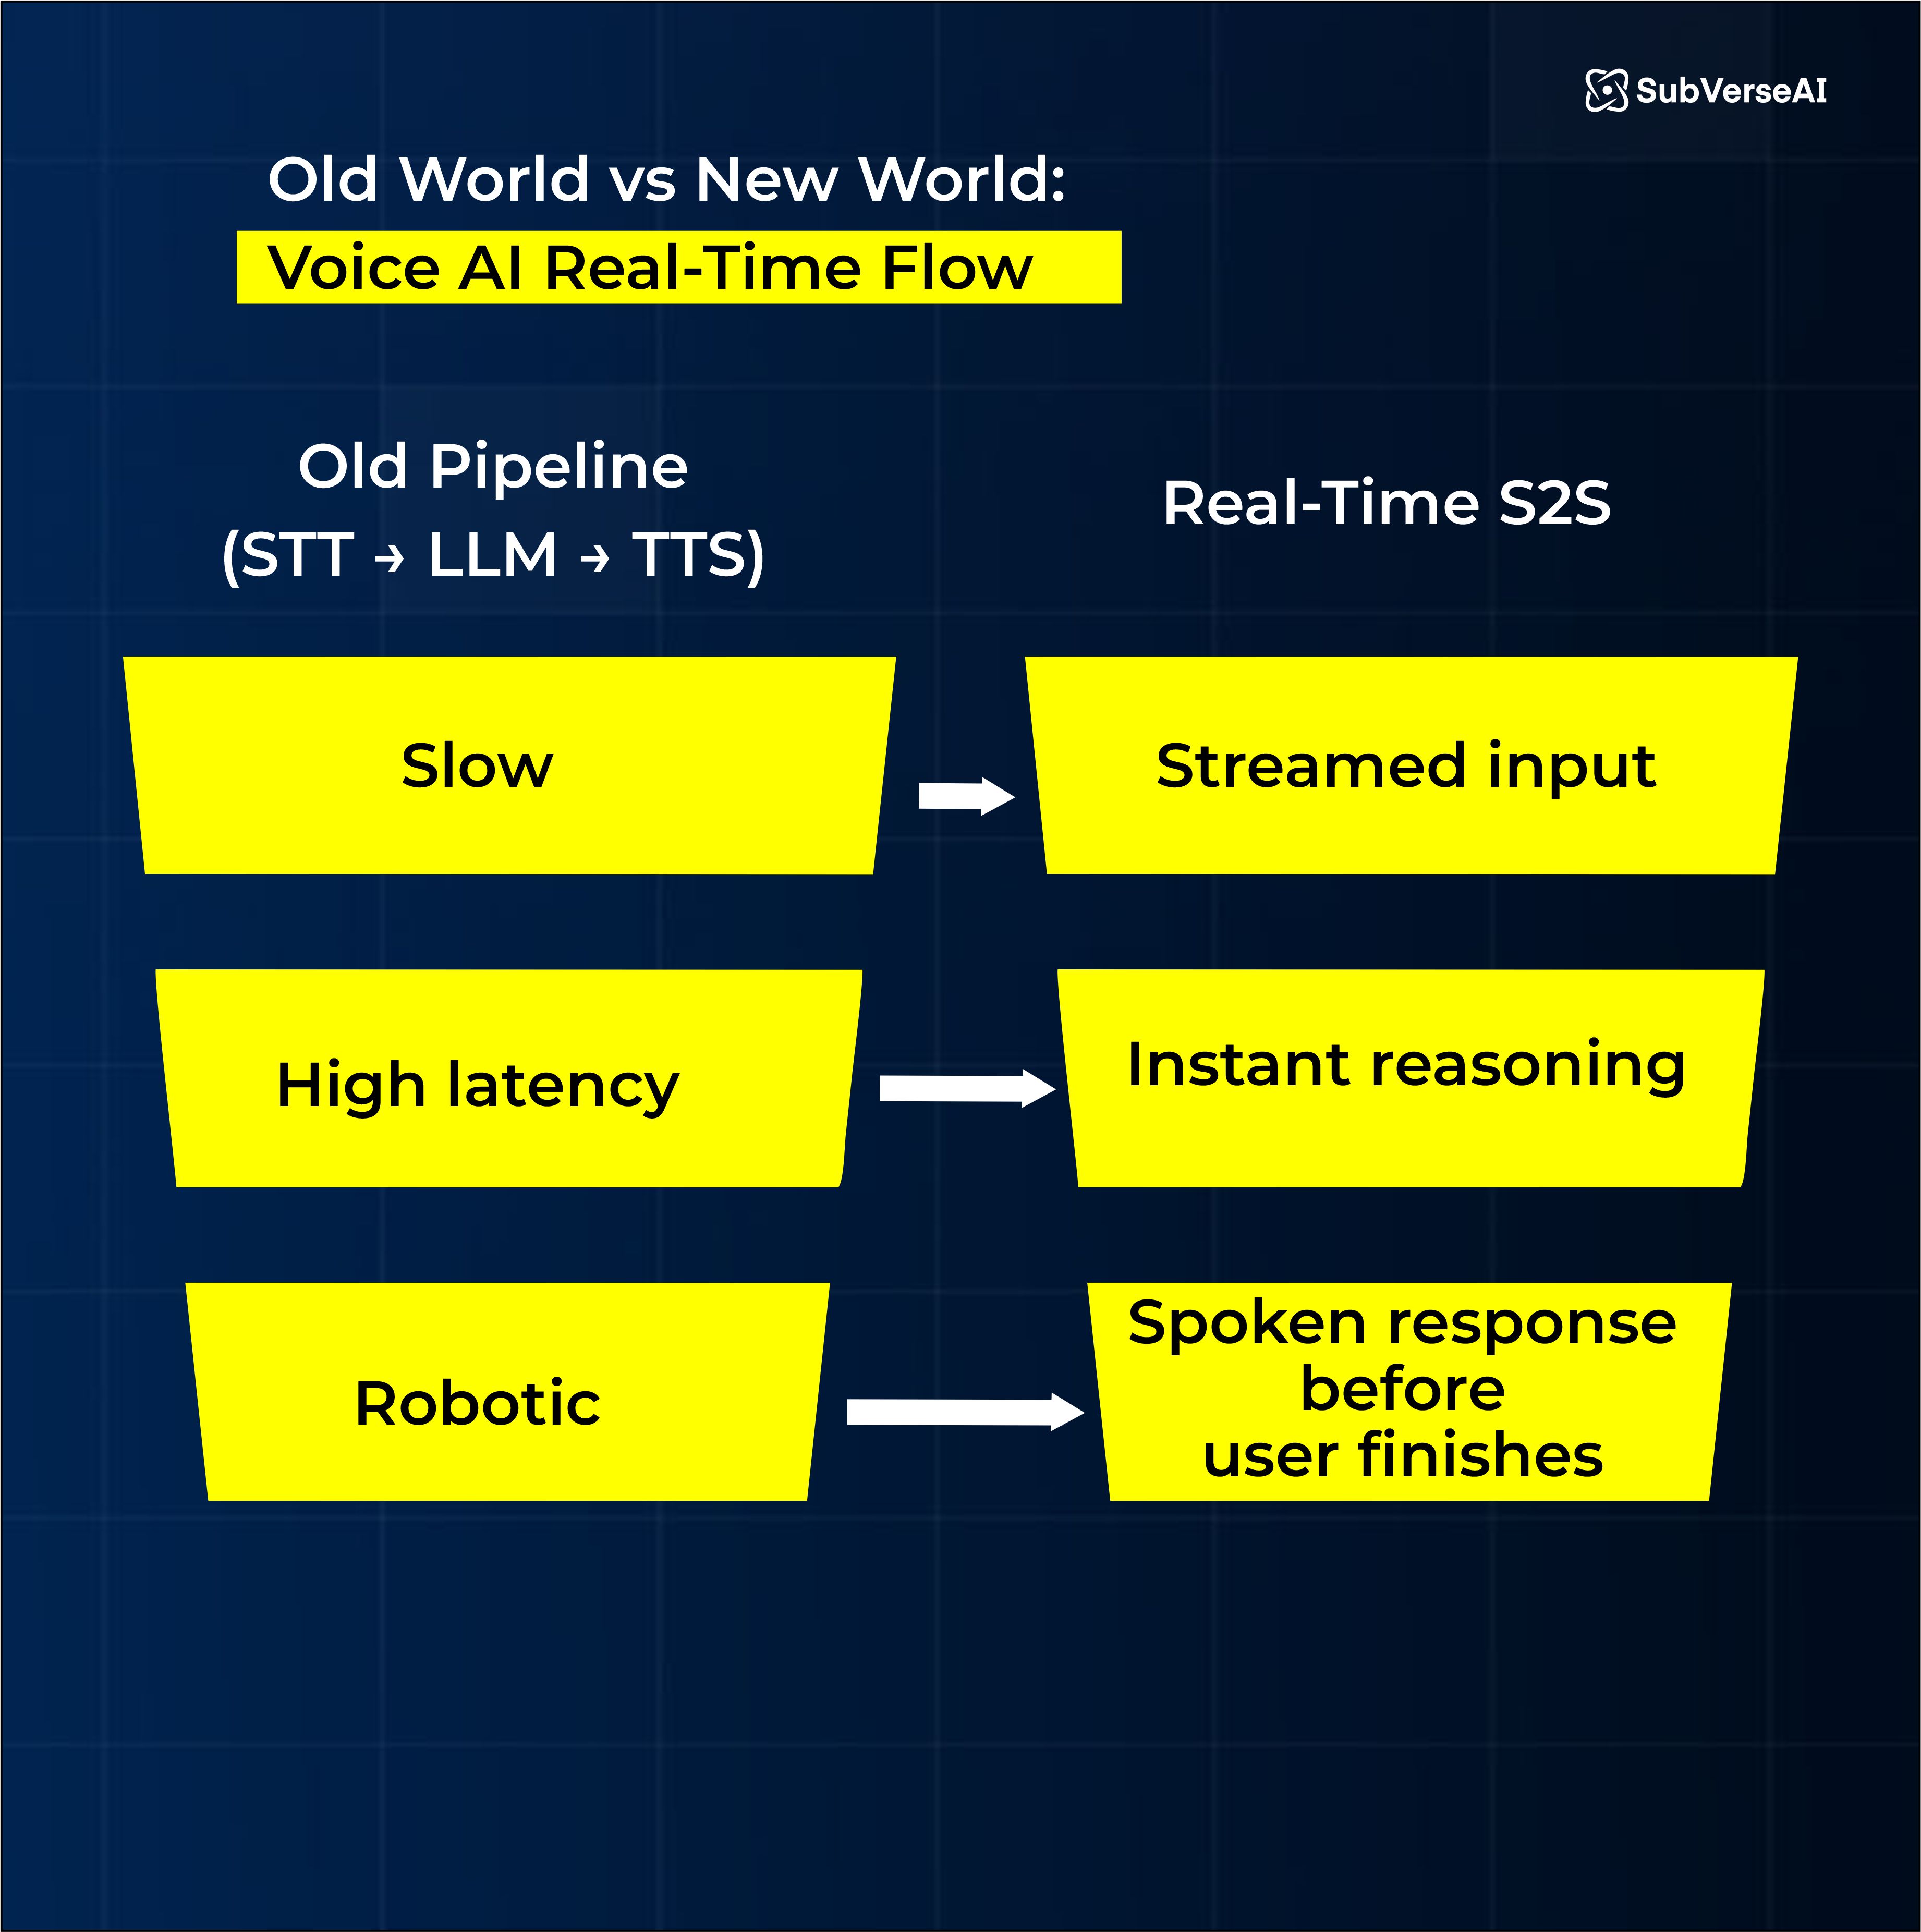
لماذا تبدو نماذج الكلام إلى كلام في الوقت الفعلي بشرية إلى هذا الحد
تتيح تقنية تحويل الصوت إلى صوت (S2S) في الوقت الفعلي حالات استخدام لم تكن مسارات العمل القديمة قادرة على دعمها ببساطة.
1. استجابات قائمة على العاطفة
يمكن لنماذج S2S تكييف نبرة الصوت - سواء كانت دافئة، أو مبهجة، أو هادئة، أو رسمية - بشكل فوري أثناء المحادثة.
مثالية للمعلمين، أو المدربين، أو مسؤولي المبيعات، أو حتى فرق دعم العملاء.
2. مرونة متعددة اللغات
التبديل بين الهندية، والتاميلية، والإنجليزية، وغيرها - في منتصف المحادثة.
خيار رائع لمنتجات SaaS المحلية للغاية والشركات الناشئة في مجال الذكاء الاصطناعي الصوتي التي تبني تجارب جاهزة للانطلاق عالمياً.
3. زمن استجابة منخفض للغاية
تأخير لا يكاد يُذكر = لا فترات توقف محرجة، ولا تبادل أدوار روبوتي مصطنع.
تبدو أشبه بمحادثة طبيعية وأقل شبهاً بالاستبيان.
إذا كنت قد استخدمت معلماً ذكياً حديثاً مدعوماً بالذكاء الاصطناعي أو روبوت دعم "سريع الاستجابة"، فقد شعرت بالفعل بالفرق.
ولكن... تقنية S2S ليست مثالية (بعد)
حتى أفضل أنظمة الذكاء الاصطناعي الصوتي في الوقت الفعلي تتعثر. إليك أين يحدث ذلك:
1. ليست بارعة في المنطق المعقد ومتعدد الخطوات
هل تحتاج إلى استدعاءات واجهات برمجة التطبيقات (API)، أو عمليات كتابة في قواعد البيانات، أو مسارات عمل إجرائية؟
لا يزال المسار الكلاسيكي (تحويل الكلام إلى نص STT ← النموذج اللغوي الكبير LLM ← تحويل النص إلى كلام TTS) هو الفائز.
2. استدعاء الدوال لا يزال في مرحلة التطور
تمنح نماذج الوقت الفعلي الأولوية للطلاقة على حساب الدقة، مما قد يؤدي إلى أخطاء عندما يتطلب الأمر الالتزام بقواعد عمل صارمة.
3. شديدة الحساسية للتداخلات والضوضاء
لا يزال الحديث المتداخل واللهجات والضوضاء المحيطة قادرة على إرباكها أكثر بكثير مقارنة بمسارات العمل القائمة على النصوص أولاً.
متى تستخدم تحويل الكلام إلى كلام في الوقت الفعلي مقابل المسار التقليدي
اعتمد على S2S عندما تتطلب حالة الاستخدام الخاصة بك ما يلي:
تفاعلاً سريعاً ومتبادلاً
فروق دقيقة في المشاعر
محادثة ثنائية الاتجاه
كلاماً طبيعياً ومستمراً
الأنسب لـ:
✔ التدريس والتعليم باستخدام الذكاء الاصطناعي
✔ روبوتات التدريب أو العلاج النفسي
✔ الدعم الخفيف
✔ الحجوزات والتذكيرات والمهام البسيطة
✔ البحث الحواري
التزم بالمسار التقليدي (Pipeline) عندما يتعلق الأمر بـ:
سير عمل متعدد الخطوات
عمليات التكامل مع الأنظمة الخلفية
استدعاء الدوال (Function calling)
تصعيد الحالات والدقة العالية
البيئات ذات متطلبات الامتثال الصارمة
الأنسب لـ:
✔ إجراءات عمل التأمين
✔ أتمتة العمليات المصرفية
✔ عمليات التكامل للمؤسسات والشركات
✔ الوكلاء الصوتيون الذين يُشغّلون الإجراءات
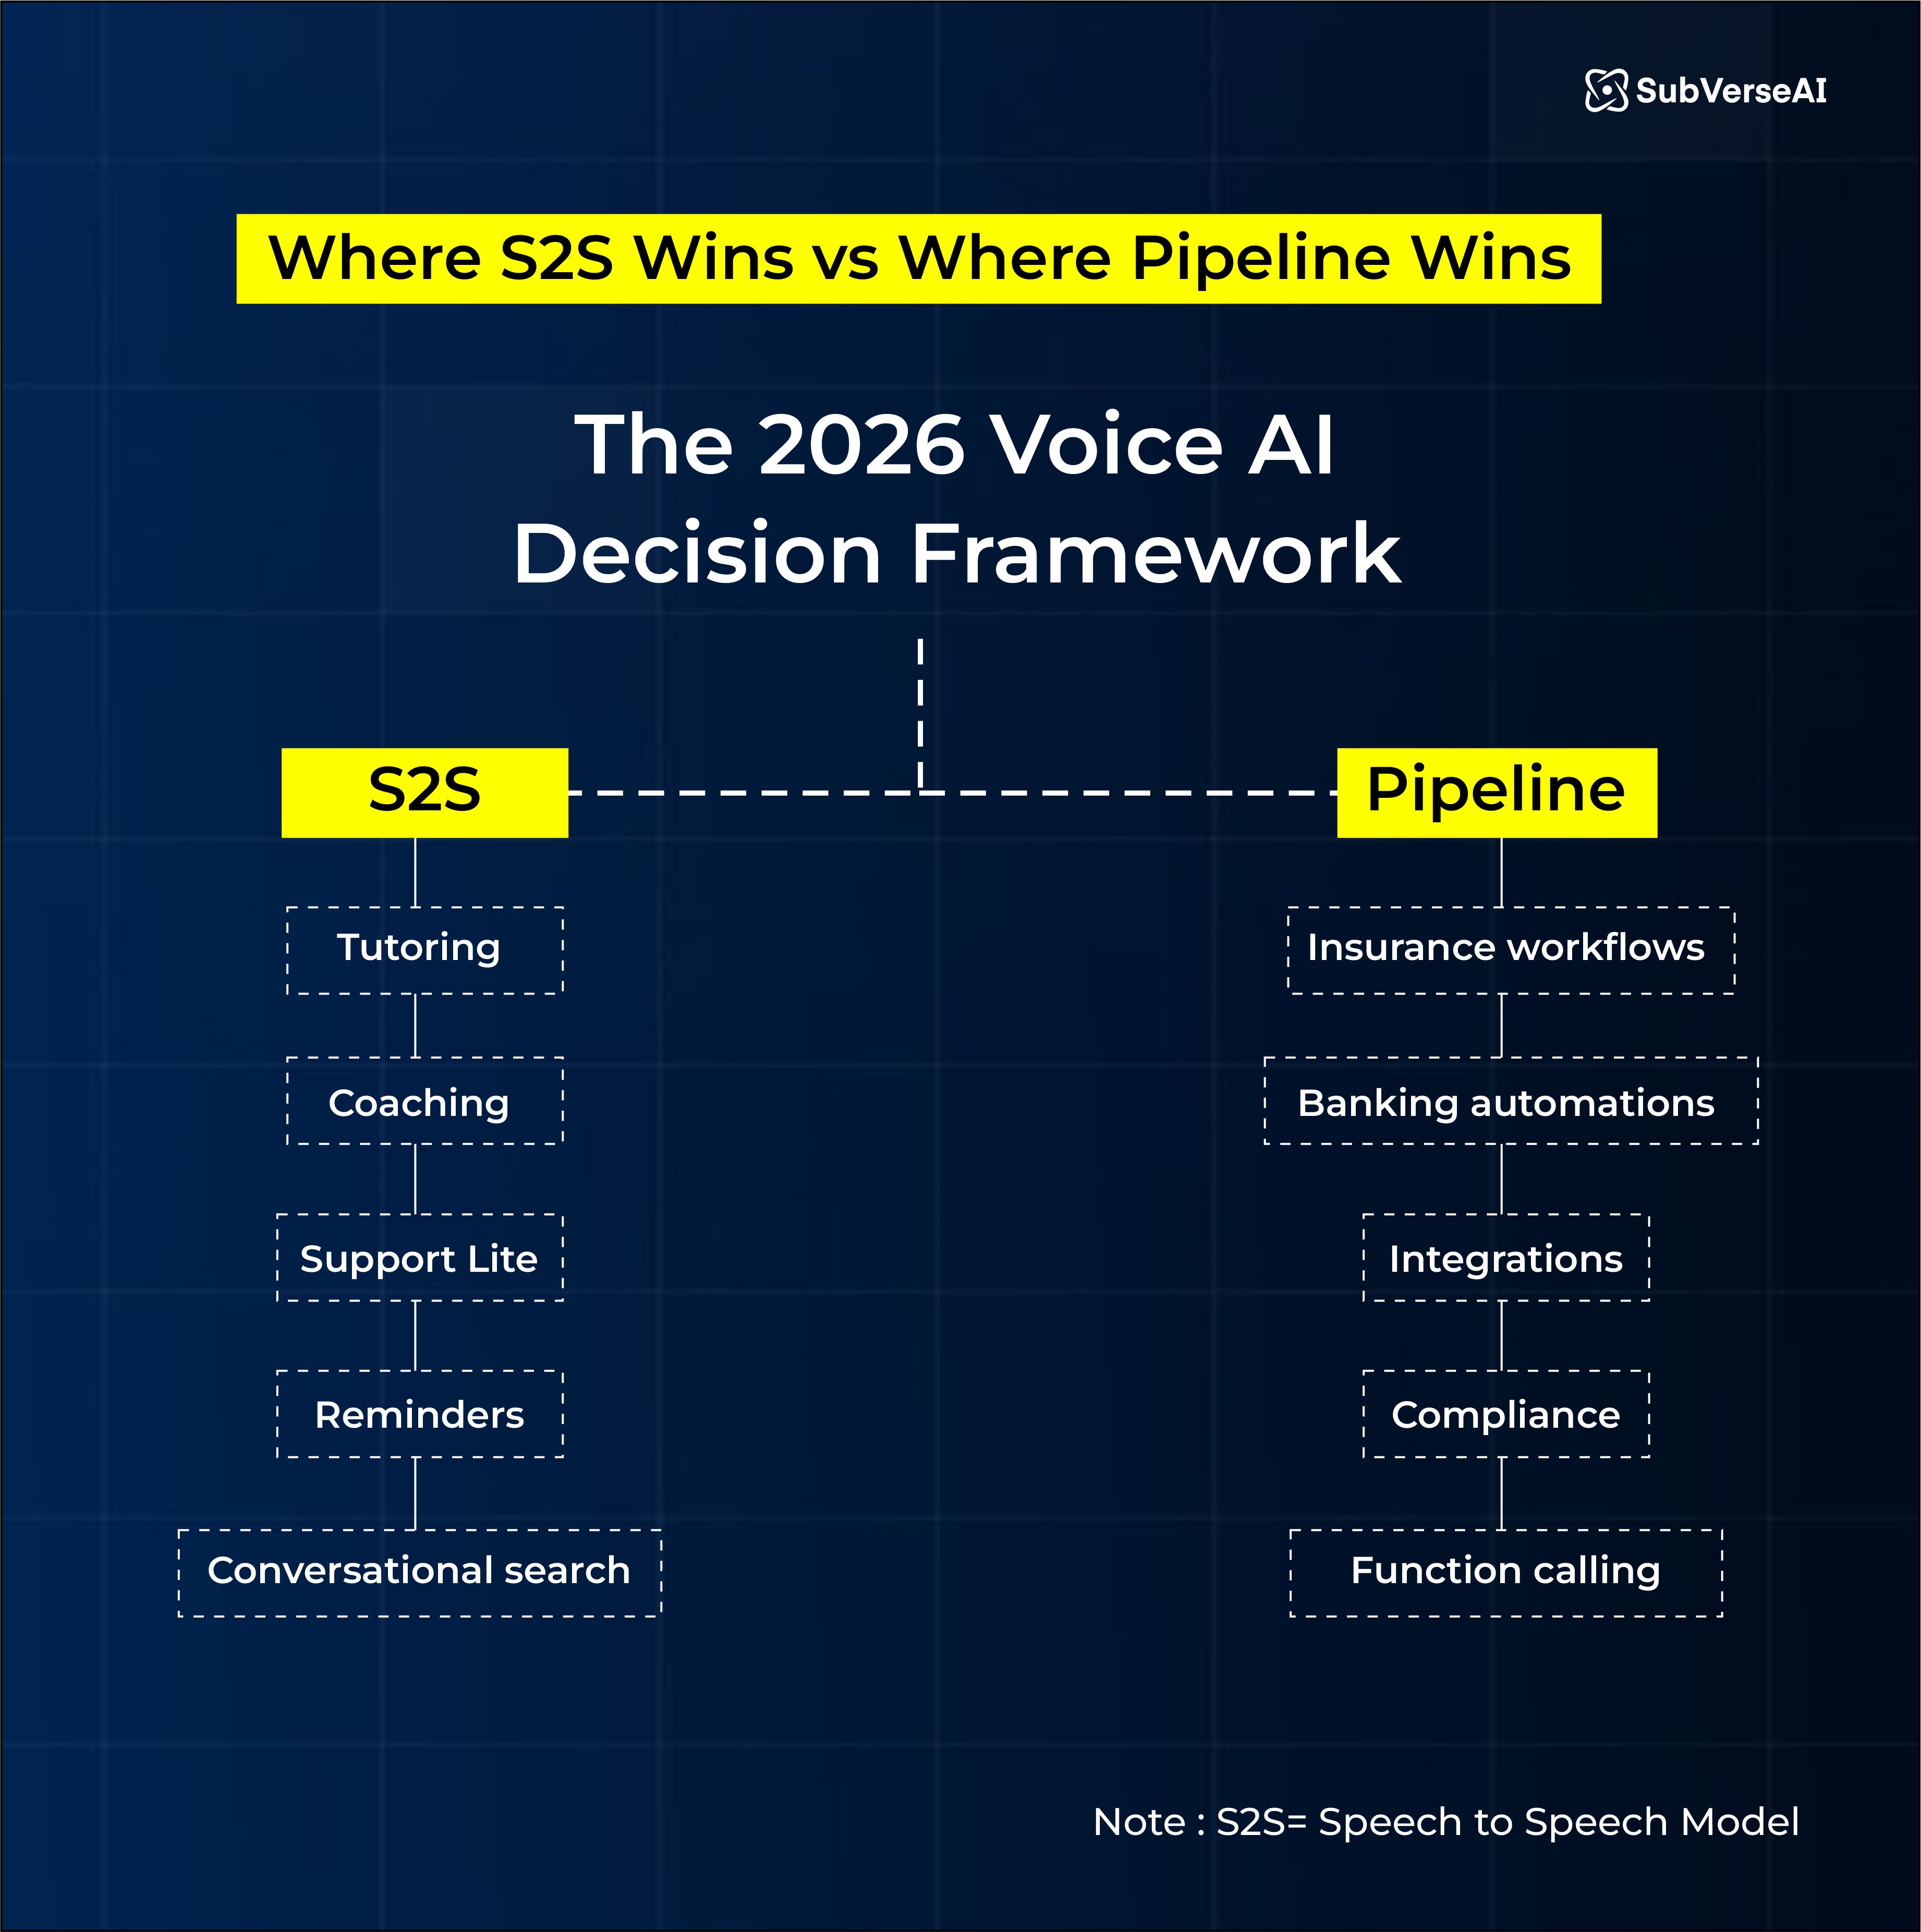
خلاصة القول: إلى أين يتجه الذكاء الاصطناعي الصوتي؟
لا تقتصر نماذج S2S في الوقت الفعلي على كونها مجرد ترقية عادية، بل إنها تعيد صياغة قواعد اللعبة بالكامل لكيفية قيام الشركات الناشئة في مجال الذكاء الاصطناعي الصوتي ببناء منتجات المحادثة.
ومع قيام منصات مثل OpenAI وGoogle بتخطي الحدود وأدوات البنية التحتية مثل LiveKit التي تتيح البث عالي الجودة، فإننا ندخل حقبة حيث:
تتحدث فيها وكلاء الذكاء الاصطناعي كالبشر
وتستجيب كالبشر
وتفكر بشكل متزايد كالبشر في الوقت الفعلي
في SubVerse AI، نحن ننقل هذا المستقبل إلى مرحلة الإنتاج الفعلي - من خلال دعم نماذج S2S في الوقت الفعلي، ومسارات البث، والبنى الهجينة حتى تتمكن الشركات من بناء وكلاء صوتيين ينبضون بالحياة حقاً.
في المرة القادمة التي تتحدث فيها إلى الذكاء الاصطناعي وتشعر بأنه طبيعي ومثالي، فإنك تختبر نتيجة محادثة تم تصميمها هندسياً بعمق - لتبدو عفوية وبلا عناء.
جدول المحتويات
المزيد من الرؤى والأفكار