14/07/2026

لم يكن بناء نموذج تجريبي للذكاء الاصطناعي الصوتي أسهل من أي وقت مضى. فمع توفر نماذج التعرف على الكلام، والنماذج اللغوية الكبيرة، ومحركات تحويل النص إلى كلام بسهولة، يمكن للفرق تجميع وكيل صوتي فعال في غضون أيام قليلة. لكن التحدي الحقيقي يبدأ بعد هذا العرض التوضيحي، عندما يُتوقع من هذا النظام التعامل مع آلاف المحادثات مع العملاء، والاندماج مع سير العمل في المؤسسة، والعمل بموثوقية في ظل ظروف العالم الحقيقي.
تعتبر بيئات الإنتاج الفعلية أقل قابلية للتنبؤ بها بكثير مقارنة بالعروض التوضيحية المضبوطة. فالعملاء ينتقلون بين اللغات دون سابق إنذار، ويتحدثون عبر خطوط هاتفية مليئة بالضجيج، ويشاركون أسماءً، وعناوين، وأرقام وثائق، ومعلومات أخرى لا تحتمل الخطأ في السمع، ويتوقعون ردوداً تبدو فورية. إن تأخيراً لبضع مئات من الأجزاء من الثانية أو خطأً واحداً في نسخ الصوت يمكن أن يقاطع المحادثة، أو يقلل من ثقة العميل، أو يتسبب في أخطاء ضمن الأنظمة اللاحقة المرتبطة.
لهذا السبب، فإن الحوار الدائر حول الذكاء الاصطناعي الصوتي آخذ في التغير. لم تعد المؤسسات تتساءل عما إذا كان بإمكان الوكيل الصوتي إجراء محادثة، بل تريد أن تعرف ما إذا كان بإمكانه إنجاز مهمة بدقة، والتكامل مع الأنظمة الحالية، والاستمرار في الأداء بموثوقية مع تزايد الاستخدام. وقد دفع هذا التحول الفرق الهندسية إلى التركيز على التنسيق الشامل، والتعرف على الكلام متعدد اللغات، ووقت الاستجابة (زمن الوصول)، والتقييم، وذكاء سير العمل بدلاً من الاقتصار على أداء النماذج الفردية.
يستكشف هذا المقال القرارات الهندسية الكامنة وراء الذكاء الاصطناعي الصوتي الجاهز لبيئات الإنتاج، استناداً إلى رؤى مستمدة من نقاش مع أوتكارش شوكلا، المؤسس المشارك ورئيس الذكاء الاصطناعي في Ringg AI، والذي استضافه مجتمع Unio Voice AI. وبدلاً من التركيز على تقنية شركة واحدة، يبحث المقال في الدروس الأوسع التي يمكن لفرق المؤسسات تطبيقها عند الانتقال من النماذج الأولية إلى بيئات الإنتاج الفعلية.
النسخة التجريبية سهلة، لكن التحدي الحقيقي يكمن في مرحلة الإنتاج
أصبح الذكاء الاصطناعي الصوتي أحد أسرع مجالات الذكاء الاصطناعي للمؤسسات نمواً. فقد ساهمت النماذج مفتوحة المصدر، وواجهات برمجة التطبيقات التجارية، والخدمات السحابية المُدارة في خفض الحواجز أمام الدخول في هذا المجال، مما جعل بناء التطبيقات المحادثية أسرع بكثير مقارنة بما كان عليه الحال حتى قبل بضع سنوات.
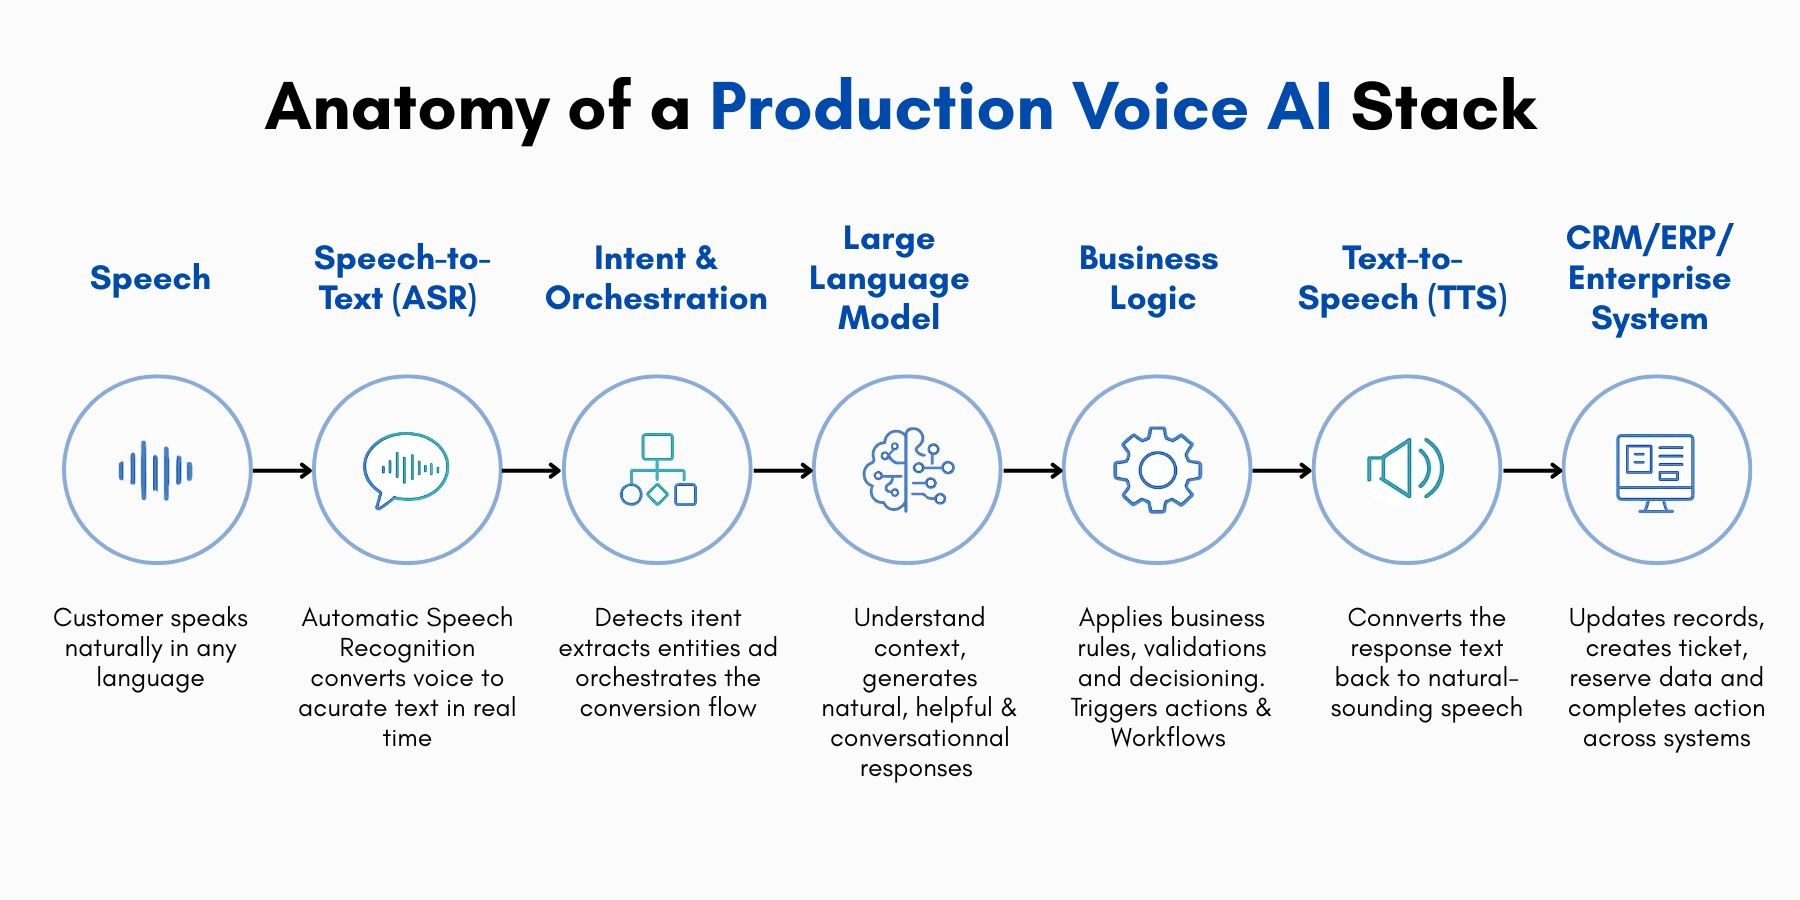
أصبحت البنية الأساسية مألوفة الآن؛ إذ يتم تحويل الكلام إلى نص باستخدام تقنية التعرف التلقائي على الكلام (ASR)، ثم معالجته بواسطة نموذج لغوي كبير (LLM)، ثم تحويله مجدداً إلى كلام عبر محرك تحويل النص إلى كلام (TTS). وبإضافة بعض عمليات التكامل مع أنظمة الأعمال، يمكن إنشاء مساعد صوتي عملي في غضون أيام بدلاً من أشهر.
وفقاً لتقرير سوق الذكاء الاصطناعي المحادثي الصادر عن Grand View Research، يواصل تبني المؤسسات لهذه التقنيات تسارعه مع استثمار المؤسسات في دعم العملاء المدعوم بالذكاء الاصطناعي، والمساعدين الافتراضيين، والتفاعل المؤتمت عبر قطاعات مثل الرعاية الصحية، والخدمات المصرفية، وتجارة التجزئة، والتجارة الإلكترونية.
ومع ذلك، لا تمثل التكنولوجيا سوى جزء واحد من المعادلة.
فنادرًا ما تحدث المحادثات الفعلية في بيئات الإنتاج في ظل ظروف مثالية. إذ يجيب العملاء على المكالمات أثناء التنقل أو العمل أو الحركة في بيئات مزدحمة. كما يتنقلون بسلاسة بين اللغة الإنجليزية واللغات الإقليمية، ويقاطعون الإجابات، ويغيرون الموضوعات في منتصف المحادثة، ويتوقعون من النظام مجاراتهم دون فقدان سياق الحديث. وفي الوقت نفسه، تتوقع الشركات التقاط كل اسم عميل، أو عنوان، أو رقم وثيقة تأمين، أو تاريخ موعد، أو تفاصيل حساب بدقة متناهية لأن هذه المحادثات تغذي الأنظمة التشغيلية مباشرة.
وهنا تحديداً تبدأ العديد من عمليات نشر الذكاء الاصطناعي الصوتي في مواجهة الصعوبات. فسير العمل الذي يعمل بشكل ممتاز في عرض توضيحي خاضع للتحكم قد يتعطل بمجرد مواجهته لصوت مشوش، أو محادثات متعددة اللغات، أو ضغط الصوت عبر الهاتف، أو زمن انتقال الشبكة، أو معلومات حساسة للأعمال لا تترك مجالاً للخطأ. إن بناء خط المعالجة أمر بسيط نسبياً، ولكن تشغيله بشكل موثوق على مستوى المؤسسات أصعب بكثير.
لقد أصبحت هذه الفجوة بين أداء النموذج الأولي والموثوقية في بيئة الإنتاج أحد أبرز التحديات الهندسية الحاسمة في مجال الذكاء الاصطناعي الصوتي للمؤسسات.
خلال جلسة نقاش عُقدت مؤخراً واستضافتها منصة Unio Voice AI Community، أوضح أوتكارش شوكلا أن هدف فريقه لم يكن يوماً مجرد التحول إلى شركة أخرى لنماذج الأساس، بل كان التركيز منصباً على بناء أنظمة تحل مشكلات الأعمال باستمرار وموثوقية في بيئات الإنتاج الفعلية.
يعكس هذا المنظور تحولاً أوسع نطاقاً يشهده هذا القطاع بأكمله. فبدلاً من التساؤل عن النموذج الأفضل أداءً في الاختبارات القياسية، باتت الفرق الهندسية تطرح سؤالاً مختلفاً بصورة متزايدة:
ما الذي يمنع الذكاء الاصطناعي الصوتي من النجاح بمجرد وصوله إلى مرحلة الإنتاج؟
نادراً ما نجد الإجابات في لوحات نتائج الاختبارات القياسية؛ بل تنبع من محادثات العملاء الحقيقية حيث يحدد الكلام متعدد اللغات، وجودة الاتصال الهاتفي، وزمن الاستجابة، والتكامل مع سير العمل، والتعرف الدقيق على الكيانات، ما إذا كان التفاعل سينجح أم سيفشل.
وتُشكل هذه الحقائق في بيئة الإنتاج كل قرار هندسي يتبعها، بدءاً من التعرف على الكلام وتحسين زمن الاستجابة، وصولاً إلى أطر التقييم وتصميم مسار تجربة العميل. ويستعرض بقية هذا المقال الخيارات التقنية وتلك المتعلقة بالمنتج التي تسهم في سد الفجوة بين عرض توضيحي مبهر ونظام يمكن للمؤسسات الاعتماد عليه يومياً.
عندما لا تكون نماذج التعرف على الصوت الجاهزة كافية
بالنسبة لمعظم فرق الذكاء الاصطناعي الصوتي، نادراً ما يكون بناء نموذج للتعرف على الكلام من الصفر هو الخيار الأول.
توفر منظومة اليوم بالفعل أنظمة قادرة على التعرف على الكلام، بدءاً من النماذج مفتوحة المصدر مثل Whisper وحتى المنصات التجارية مثل Deepgram وGoogle Cloud Speech-to-Text. تجعل هذه الأدوات من الممكن إطلاق تطبيقات صوتية بسرعة دون استثمار سنوات في تطوير النماذج.
يعمل هذا النهج بشكل جيد إلى أن تفرض بيئة الإنتاج الفعلية ظروفاً نادراً ما ترصدها مجموعات البيانات المعيارية.
المحادثات في بيئات العمل معقدة وغير منتظمة؛ فالصوت يمر عبر شبكات هاتفية مضغوطة، والضوضاء في الخلفية شائعة، وكثيراً ما ينتقل العملاء بين اللغة الإنجليزية واللغات الإقليمية ضمن الجملة نفسها. النموذج الذي يؤدي بشكل جيد في التقييمات المضبوطة قد يواجه صعوبات عند نشره في تفاعلات العملاء الواقعية.
يتجاوز التحدي مجرد دقة تحويل الصوت إلى نص.
تعتمد الشركات على الذكاء الاصطناعي الصوتي لالتقاط المعلومات التي تقود مسارات العمل اللاحقة. إن عدم سماع اسم العميل بشكل صحيح قد يتسبب في تكرار السجلات داخل نظام إدارة علاقات العملاء (CRM). وقد يؤدي العنوان غير الصحيح إلى تعطيل عمليات التسليم. كما أن عدم التقاط رقم وثيقة التأمين أو تاريخ الموعد يمكن أن يؤثر على رحلة العميل بأكملها. في هذه الحالات، يصبح الخطأ الفردي في التعرف على الصوت مشكلة في سير الأعمال وليس مجرد خطأ في النموذج.
هذا التحدي كان موضوع نقاش خلال المحادثة مع أوتكارش شوكلا، الذي أوضح أن فريقه توصل في النهاية إلى أن عنق الزجاجة لم يكن في هندسة الأوامر (prompting) أو التنسيق والتنظيم (orchestration). بل كان التعرف الأساسي على الكلام في حد ذاته بحاجة إلى تحسين ليتناسب مع البيئات التي يتفاعل فيها العملاء فعلياً مع النظام.
"الأداء في الاختبارات المعيارية ليس كافياً؛ فبيئات الإنتاج الفعلية تتطلب نماذج محسنة لتلائم واقع الأعمال الخاص."
بدلاً من السعي وراء تحقيق أدنى معدل ممكن لخطأ الكلمات (WER) عبر مجموعات بيانات عامة، سلط النقاش الضوء على فلسفة تصميم مختلفة: تحسين التعرف على الكلام للبيئات التي سيعمل فيها فعلياً. وهذا يعني أخذ الصوت عبر الهاتف، والمحادثات متعددة اللغات، والظروف الصاخبة، والالتقاط الدقيق للمعلومات الحيوية للأعمال في الحسبان.
في مختلف قطاعات الصناعة، تقوم الفرق بتقديم تنازلات ومفاضلات مماثلة. فبدلاً من الاعتماد كلياً على النماذج التأسيسية للأغراض العامة، يعملون على بناء طبقات متخصصة أو نماذج مخصصة لمجالات معينة حيث يكون للموثوقية تأثير مباشر على تجربة العملاء ونتائج الأعمال.
الدرس الأوسع نطاقاً واضح: الذكاء الاصطناعي للمؤسسات لا يتمحور دائماً حول اختيار النموذج الأكبر أو الأحدث، بل يتعلق أحياناً بإدراك حدود التكنولوجيا العامة والاستثمار في أنظمة مصممة لبيئة إنتاج محددة.

لماذا يجب أن يكون بناء نموذج الذكاء الاصطناعي الخاص بك قراراً تجارياً، وليس مجرد هدف هندسي
تبدأ معظم فِرق الذكاء الاصطناعي بالافتراض نفسه: استخدام أفضل النماذج المتاحة والتركيز على بناء المنتج حولها. ومع توفر نماذج التعرف على الكلام عالية الجودة بالفعل، غالباً ما يبدو بناء نموذج داخلي أمراً غير ضروري.
في كثير من الحالات، يكون هذا الافتراض صحيحاً.
لقد جعلت النماذج التأسيسية من الممكن بناء أنظمة ذكاء اصطناعي صوتية ذات كفاءة عالية دون استثمار سنوات في أبحاث النماذج. وبالنسبة للشركات الناشئة على وجه الخصوص، يُعد شراء القدرات الحالية عادةً أسرع وأرخص وأسهل من بنائها من الصفر.
تتغير المعادلة عندما تبدأ متطلبات بيئة الإنتاج الفعلية في كشف مشكلات لم تُصمم النماذج العامة لحلها في الأساس.
نادراً ما تشبه المحادثات الهاتفية للمؤسسات مجموعات البيانات المرجعية المعتمدة. فالعملاء يتحدثون عبر شبكات هاتف متحرك مضغوطة، ويبدلون بين اللغات في منتصف الجملة، ويتصلون من بيئات صاخبة، ويشاركون أسماءً، وعناوين، وأرقام وثائق تأمين، ومعلومات أخرى يجب التقاطها بدقة. وفي ظل هذه الظروف، حتى أخطاء النسخ البسيطة يمكن أن تؤدي إلى مشكلات لاحقة في سير العمل التجاري.
كان هذا أحد المحاور التي برزت خلال المناقشة. وبدلاً من محاولة التفوق على كل نماذج التعرف على الكلام في المؤشرات المعيارية العامة، تحول التركيز إلى تحسين تقنية التعرف على الكلام لتناسب البيئات التي تعمل فيها أنظمة المؤسسات فعلياً. وبالنسبة لشركة Ringg AI، أدى ذلك إلى تطوير Parrot، وهو نظام داخلي لتحويل الكلام إلى نص مصمم لشبكات الاتصالات الهندية، والمحادثات متعددة اللغات، والاستخراج الدقيق للمعلومات الحيوية للأعمال.
ويمتد الدرس الأوسع إلى ما هو أبعد من مجرد التعرف على الكلام.
فبناء بنية تحتية خاصة للذكاء الاصطناعي نادراً ما يمثل ميزة تنافسية بحد ذاته. بل يصبح ذا قيمة فقط عندما يعالج قيداً تجارياً محدداً تعجز النماذج الجاهزة عن حله باستمرار. وسواء كان التحدي يتمثل في زمن الاستجابة، أو الدعم متعدد اللغات، أو الامتثال، أو التكلفة، أو الدقة في مجال متخصص، يجب أن يكون قرار البناء مدفوعاً بالنتائج المرجوة للعملاء بدلاً من مجرد الطموح الهندسي.
بالنسبة لمعظم المؤسسات، سيظل شراء النماذج الحالية هو الخيار الصائب. أما الشركات التي تنجح في بناء نماذجها الخاصة، فإنها تميل إلى فعل ذلك فقط بعد تحديد عقبة إنتاجية واضحة لا يمكن لأي حل حالي معالجتها بشكل مناسب.
زمن الاستجابة يشكّل كل محادثة
يمكن لنظام الذكاء الاصطناعي الصوتي أن يفهم كل عميل بشكل صحيح ومع ذلك يقدم تجربة سيئة إذا كانت استجابته بطيئة للغاية.
تعتمد المحادثات البشرية على الإيقاع؛ فالناس يتوقعون بطبيعتهم الحصول على ردود في غضون أجزاء من الثانية، وحتى فترات الصمت القصيرة يمكن أن تجعل التفاعل يبدو محرجاً أو مصطنعاً. وخلافاً لواجهات الدردشة، لا تترك المحادثات الصوتية مجالاً كبيراً للتأخير، فكل ميلي ثانية إضافية تؤثر على مدى تلقائية المحادثة وطبيعتها.
وهذا ما يجعل زمن الاستجابة (Latency) أحد أكبر التحديات الهندسية في تطبيقات الذكاء الاصطناعي الصوتي الفعلية.
إن تقليل زمن الاستجابة نادراً ما يقتصر على تسريع نموذج واحد، فكل تفاعل للعميل يمر عبر مراحل متعددة قبل سماع الرد؛ حيث يجب تحويل الكلام إلى نص، ثم تفسيره بواسطة نموذج لغوي، ومطابقته مع منطق الأعمال، ثم إعادة تحويله إلى كلام، ونقله عبر شبكة الهاتف. وحتى التأخيرات الصغيرة في كل مرحلة تتراكم سريعاً.
وقد برزت نقطة أساسية في المناقشة: لكي تبدو المحادثات طبيعية، يُفضل أن يصل أول رد مسموع خلال 500 إلى 600 ميلي ثانية. وعندما تقترب أوقات الاستجابة من 800 إلى 900 ميلي ثانية، يبدأ المستخدمون في ملاحظة التأخير، مما يجعل التفاعلات تبدو أقل سلاسة حتى وإن بقيت الإجابات دقيقة.
ولهذا السبب، تتجه فرق العمل في المؤسسات بشكل متزايد نحو تحسين مسار عمل الذكاء الاصطناعي الصوتي بالكامل بدلاً من التركيز على نماذج فردية. فموقع البنية التحتية، والبث المباشر للبيانات، والتنسيق الإجرائي، والاستدلال، وأداء الشبكة، كلها عوامل تسهم في مدى سرعة استجابة النظام.
في النهاية، لا يُعد زمن الاستجابة مجرد مقياس هندسي، بل هو مقياس لتجربة العملاء. ففي أنظمة الذكاء الاصطناعي الصوتي قيد التشغيل، غالباً ما تُكتسب الثقة أو تُفقد خلال أول بضع مئات من الميلي ثانية من كل محادثة.
عندما لا تكون الدقة كافية
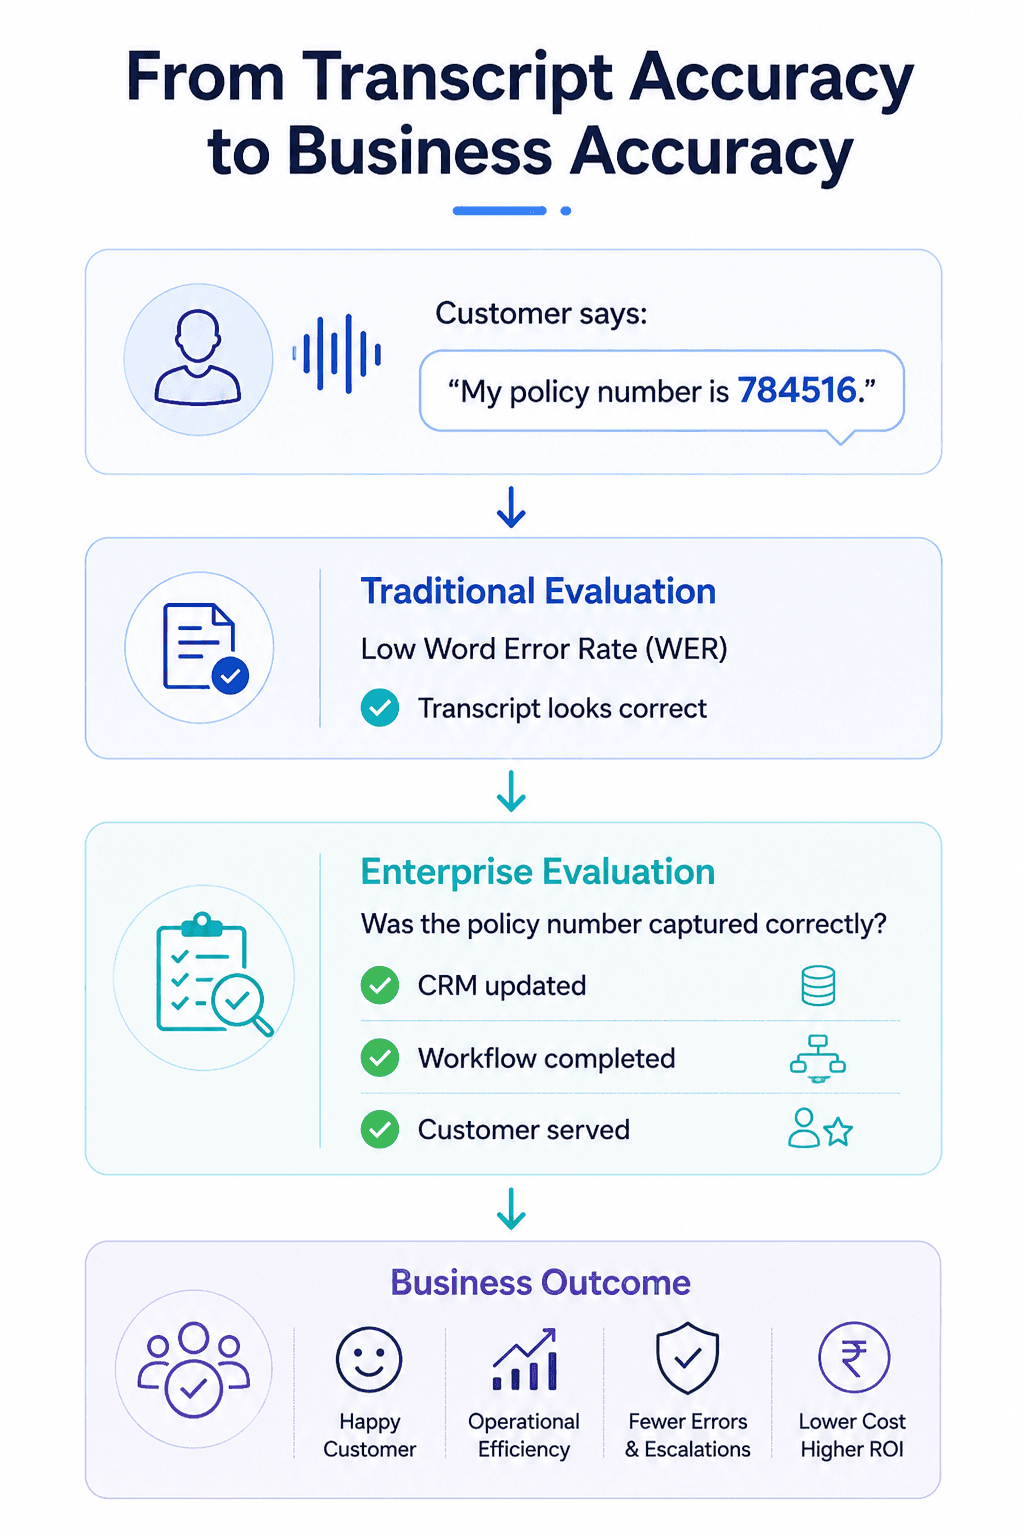
لطالما كان معدل الخطأ في الكلمات (WER) هو المعيار الأساسي المعتمد لتقييم أنظمة التعرف على الكلام. فمن خلال مقارنة النص المنطوق المفرغ بنص مرجعي، يقيس هذا المعيار عدد الكلمات التي تم استبدالها، أو حذفها، أو إدراجها. ويشير انخفاض معدل الخطأ في الكلمات (WER) عموماً إلى دقة تفرريغ أفضل.
بالنسبة للمقارنة بين نماذج الكلام، يظل معدل الخطأ في الكلمات معياراً مفيداً.
ومع ذلك، يتطلب الذكاء الاصطناعي الصوتي للمؤسسات مقياساً مختلفاً للنجاح.
فقد يحقق النص المفرغ معدل خطأ ممتازاً في الكلمات، لكنه يفشل في إنجاز مهمة العمل التي كان من المفترض أن يدعمها. وإذا تم تسجيل اسم العميل، أو عنوانه، أو رقم وثيقة التأمين، أو تاريخ الموعد، أو معرف الحساب بشكل غير صحيح، فقد يبدو النص المفرغ دقيقاً إلى حد كبير، لكن مسار العمل الذي يعتمد على هذه المعلومات قد يفشل رغم ذلك.
وهذا ما يغير السؤال الذي تطرحه المؤسسات.
فبدلاً من التساؤل: "هل قام الذكاء الاصطناعي بتفريغ كل كلمة بدقة؟"، أصبح التساؤل المتزايد: "هل التقط الذكاء الاصطناعي المعلومات المطلوبة لإكمال المهمة؟"
وقد برزت وجهة النظر هذه أيضاً خلال المناقشة مع أوتكارش شوكلا، حيث أوضح أن أنظمة الإنتاج الفعلي يتم تقييمها بما يتجاوز درجات المعايير التقليدية. فالتركيز ينصب على تحديد الكيانات المهمة لبيئة العمل بدقة، لأن تلك التفاصيل هي التي تحدد مدى نجاح مسارات العمل اللاحقة.
وتعمل العديد من فرق المؤسسات الآن على استكمال اختبارات المقارنة المعيارية من خلال مسارات تقييم مستمرة تقيس أداء الذكاء الاصطناعي في محادثات العملاء الحقيقية بدلاً من مجموعات البيانات الخاضعة للرقابة. والهدف ليس مجرد إنتاج نصوص مفرغة أكثر نقاءً، بل ضمان وصول المعلومات الصحيحة إلى أنظمة الأعمال المعنية بدقة.
ومع استمرار تطور تقنيات الذكاء الاصطناعي الصوتي ونضجها، بات قياس النجاح يعتمد بدرجة أقل على المعايير الفنية وبدرجة أكبر على نتائج الأعمال. فالنموذج الذي يستخرج المعلومات الصحيحة ويتيح اتخاذ الإجراء التالي يقدّم في نهاية المطاف قيمة أكبر بكثير من نموذج يكتفي بإنتاج أدق نص مفرغ فحسب.
حل مشكلة الذكاء الاصطناعي الصوتي في الهند يبدأ بفهم الطريقة التي يتحدث بها الناس في الواقع
تفشل العديد من مشاريع الذكاء الاصطناعي الصوتي المتعدد اللغات لأنها تتعامل مع اللغة كمشكلة ترجمة بدلاً من التعامل معها كمشكلة فهم لغوي.
تُمثّل الهند واحدة من أكثر البيئات تحدياً للذكاء الاصطناعي التوليدي الحواري. فنادراً ما يتحدث العملاء بلغة واحدة من البداية إلى النهاية؛ إذ تتنقل المحادثات بشكل طبيعي بين الهندية والإنجليزية واللغات المحلية، وغالباً ما يحدث ذلك ضمن الجملة نفسها. فقد يصف العميل مشكلة ما باللغة الهندية، ويذكر اسم منتج بالإنجليزية، ثم يحدد عنواناً بلهجة محلية، ويعود للغة السابقة مجدداً دون تفكير مسبق.
هذا النوع من تبديل اللغات (Code-switching) يجعل التعرف على الكلام أكثر تعقيداً بكثير مما تشير إليه مجموعات البيانات المرجعية القياسية. وإذا أضفنا إلى ذلك ضغط إشارات الهاتف، والضوضاء المحيطة، واللهجات الإقليمية، وجودة الصوت غير المستقرة، تصبح إدارة بيئات العمل الفعلية أكثر صعوبة.
كانت هذه التحديات محوراً متكرراً خلال النقاش مع أوتكارش شوكلا. وكان أحد أبرز الملاحظات هو أن فهم السياق العام للمحادثة نادراً ما يكون كافياً؛ فالأخطاء التي تقع أثناء التعرف على الصوت تؤثر على كل ما يتبعها، بدءاً من استنتاجات النماذج اللغوية ووصولاً إلى تنفيذ مسارات العمل.
كما سلّطت المحادثة الضوء على أسباب تعثر العديد من نماذج الصوت الحالية في التعامل مع اللغات الهندية. فطرق تقسيم النصوص إلى وحدات (Tokenization) المصممة أساساً للغة الإنجليزية واللغات الغربية الأخرى لا تمثل البنية الصوتية للغات الهندية دائماً بشكل فعال. وبناءً على ذلك، يتطلب تحسين التعرف على الكلام ما هو أكثر من مجرد إضافة دعم للغات؛ إذ يستلزم ذلك تمثيلاً لغوياً أفضل، وبيانات تدريب تعكس الطريقة الحقيقية التي يتحدث بها الناس، وتقييماً يعتمد على محادثات فعلية حية بدلاً من مجموعات البيانات المرجعية المعالجة والنقية.
ولا يقتصر التحدي على اللغة ذاتها فحسب، إذ تتضمن مكالمات الشركات محادثات في الخلفية، وضجيج حركة المرور، وضعف جودة الشبكة، وتداخل أصوات عدة متحدثين في نفس الوقت. ويجب على الأنظمة تحديد المتحدث الرئيسي، وتجاهل الأصوات غير ذات الصلة، والاستمرار في استخراج المعلومات التي تهم الأعمال بدقة.
وهذا الدرس الأوسع ينطبق تماماً خارج حدود الهند. فبناء أنظمة ذكاء اصطناعي صوتي لأي سوق يتطلب فهم الطريقة الطبيعية التي يتواصل بها الناس بدلاً من فرض الطريقة المتوقعة لحديثهم. وكلما كانت بيانات التدريب أكثر محاكاة للسلوك الفعلي للعملاء، زادت موثوقية هذه الأنظمة في بيئات العمل الحقيقية.
الذكاء الاصطناعي الصوتي يحقق قيمة أكبر بعد انتهاء المحادثة
لا تزال العديد من المؤسسات تقيّم الذكاء الاصطناعي الصوتي بناءً على عدد المكالمات التي يمكنه أتمتتها. ورغم أن الأتمتة تقلل من الجهد اليدوي، إلا أن المحادثة بحد ذاتها نادراً ما تكون هي الهدف النهائي.
القيمة الحقيقية تكمن في كل ما يحدث بعد انتهاء المكالمة.
كل تفاعل مع العميل يولد معلومات يمكنها تحسين القرارات المستقبلية؛ فالتذكير بالمواعيد يتحول إلى فرص للمتابعة، ومحادثات الخدمة تخلق سياقاً لطلبات الدعم المستقبلية، ومكالمات المبيعات تكشف عن نية الشراء التي يمكن أن تشكل التفاعل التالي مع العميل. وبدلاً من التعامل مع كل محادثة كحدث منفصل، بدأت المؤسسات تنظر إلى الذكاء الاصطناعي الصوتي كمصدر مستمر لمعلومات ورؤى العملاء.
وقد برزت هذه الفكرة بوضوح خلال المناقشة مع أوتكارش شوكلا، حيث تجاوز التركيز مجرد أتمتة الصوت ليشمل الحفاظ على السياق عبر مختلف مراحل رحلة العميل. وبدلاً من تحسين المكالمات الفردية، يتمثل الهدف في ربط المحادثات بأنظمة الأعمال بحيث يجعل كل تفاعل التفاعلَ الذي يليه أكثر ملاءمة وأهمية.
يغير هذا التحول طريقة تقييم المؤسسات للاستثمارات في الذكاء الاصطناعي الصوتي؛ إذ لم يعد النجاح يُقاس ببساطة بحجم المكالمات أو معدلات الأتمتة، بل بات يُقاس بنتائج الأعمال مثل ارتفاع معدلات التحويل، وحل المشكلات بشكل أسرع، وتحسين الاحتفاظ بالعملاء، وتوفير تجارب أكثر تخصيصاً.
ومع تزايد اندماج الذكاء الاصطناعي الصوتي بشكل أعمق في سير العمل بالمؤسسات، تصبح المحادثة بحد ذاتها مجرد خطوة واحدة ضمن عملية أكبر بكثير. فالمؤسسات التي تحقق قيمة طويلة الأجل هي تلك التي تستفيد من كل تفاعل لبناء السياق، وتحسين القرارات، وتعزيز العلاقات مع العملاء بمرور الوقت.
ما بعد الذكاء الاصطناعي الصوتي: بناء ذكاء مؤسسي مستدام
لم يعد بناء نموذج تجريبي للذكاء الاصطناعي الصوتي هو الجزء الصعب؛ بل يتمثل التحدي الحقيقي في نشر أنظمة تواصل تقديم الأداء المطلوب في بيئات غير متوقعة، وتتكامل بسلاسة مع العمليات التشغيلية القائمة، وتحقق نتائج ملموسة وقابلة للقياس بمرور الوقت.
عبر مختلف القطاعات، تكتشف المؤسسات أن النجاح في مرحلة الإنتاج الفعلي يعتمد على ما هو أكثر بكثير من مجرد اختيار النموذج التأسيسي المناسب. يتطلب الأمر أنظمة صوتية قادرة على التعامل مع الصوتيات في العالم الواقعي، والمحادثات متعددة اللغات، والتفاعلات منخفضة زمن الاستجابة، واستخراج المعلومات بدقة، والتقييم المستمر بعد النشر. وتتحول هذه التحديات التشغيلية تدريجياً إلى العامل الحاسم الذي يميّز بين المشاريع التجريبية التي تبهر الحضور والمنصات القابلة للتوسع الفعلي.
وقد عززت مناقشتنا مع Ringg AI هذا التحول الأوسع نطاقاً. فبينما استندت الأمثلة إلى تجربة شركة واحدة، فإن الدروس المستفادة تنطبق على صناعة الذكاء الاصطناعي الصوتي بأكملها. وتضع الفرق التي تبني أنظمة للإنتاج الفعلي تركيزاً أكبر على البنية التحتية، والتنسيق المتكامل، ومسارات التقييم، والتكامل مع تدفقات العمل، بدلاً من التعامل مع أداء النموذج بمفرده كمقياس وحيد للنجاح.
ويظهر هذا التوجه نفسه عبر تبني المؤسسات للذكاء الاصطناعي على نطاق واسع؛ إذ تتجاوز المؤسسات مرحلة التجريب لتركز على كيفية دمج الذكاء الاصطناعي في العمليات التجارية بحوكمة واضحة، وعائد استثمار قابل للقياس، وقابلية للتوسع على المدى الطويل. ويسلط تقرير ديلويت واقع الذكاء الاصطناعي في المؤسسات لعام 2026 الضوء على هذا التحول، مشيراً إلى أن التحدي قد تحول من تحديد فرص الذكاء الاصطناعي إلى تطبيقها وتوسيع نطاقها بنجاح عبر أعمال المؤسسة.
هذه هي الرؤية التي تسعى SubVerse AI لتقديمها في مثل هذه الحوارات. فبدلاً من التركيز فقط على إطلاق المنتجات أو نتائج الاختبارات المعيارية، نستكشف القرارات الهندسية، والمفاضلات المعمارية، واستراتيجيات التنفيذ التي ترسم ملامح أنظمة الذكاء الاصطناعي الجاهزة للإنتاج الفعلي.
والدرس الأبرز المستفاد من هذه المناقشة بسيط للغاية؛ فمع تزايد سهولة الوصول إلى النماذج التأسيسية، لن تأتي الميزة التنافسية من النماذج نفسها بقدر ما ستأتي من مدى كفاءة وفعالية نشرها. فالشركات التي ستحقق قيمة مستدامة لن تكون بالضرورة هي التي تمتلك أضخم النماذج، بل تلك التي تبني أنظمة تحظى بثقة الناس وتعمل بكفاءة في بيئات العالم الواقعي.
نبذة عن Subverse AI
يستند هذا المقال إلى رؤى مستمدة من محادثة مع أوتكارش شوكلا، الشريك المؤسس ورئيس قسم الذكاء الاصطناعي في Ringg AI، والتي استضافها مجتمع Unio Voice AI. لاستكشاف المزيد من المحادثات حول الذكاء الاصطناعي الصوتي والذكاء الاصطناعي للمؤسسات، تابع SubVerse AI على LinkedIn وانضم إلى مجتمع متنامٍ من المؤسسين، والمطورين، وقادة المؤسسات الذين يشكّلون مستقبل الذكاء الاصطناعي.
جدول المحتويات
المزيد من الرؤى والأفكار