21/05/2026
هل سبق لك أن طرحت سؤالاً بسيطاً على مساعد صوتي لتجد نفسك مقاطَعاً في منتصف الجملة، أو تُركت منتظراً في صمت محرج؟ هذا التفاوت البسيط بين الوقت الذي يتوقع فيه البشر رداً والوقت الذي يقرر فيه الذكاء الاصطناعي التحدث يُعد واحداً من أكبر التحديات في الذكاء الاصطناعي التوليدي الصوتي.
ما هو السر الكامن وراء إجراء حوار طبيعي يشبه الحوار البشري؟
اكتشاف تبادل الأدوار (Turn detection) - هو القدرة على معرفة متى ينتهي المستخدم من الحديث بدقة، ومتى ينبغي للذكاء الاصطناعي التدخل.
إنه أمر دقيق ومعقد، وهو أحد العوامل الرئيسية التي تميز الأنظمة الصوتية العادية عن أفضل مزودي الذكاء الاصطناعي الصوتي عالمياً مع دعم الاتصالات.
في SubVerse AI، نتصدى لهذا التحدي من خلال إطار عمل ثلاثي الطبقات لاكتشاف تبادل الأدوار:
نماذج مفتوحة المصدر تراعي السياق
اكتشاف يعتمد على النشاط الصوتي
تنبؤ دلالي مدمج بتبادل الأدوار ضمن تقنية تحويل الكلام إلى نص (STT)
دعونا نفصل ذلك.
لماذا يعد اكتشاف تبادل الأدوار بالغ الصعوبة (ولماذا تفشل معظم أنظمة الذكاء الاصطناعي الصوتي فيه)
في المحادثة الحقيقية، لا يعتمد البشر على الصمت وحده. فنحن نستخدم السياق ونبرة الصوت والتردد وكلمات الحشو ووقفات الكلام الطبيعية للإشارة إلى ما إذا كنا قد انتهينا أو ما زلنا نفكر.
وعلى النقيض من ذلك، اعتمد الذكاء الاصطناعي تاريخياً على قاعدة بسيطة واحدة:
الصمت = نهاية الكلام.
ولكن الصمت يمكن أن يعني أموراً عديدة:
أنك تفكر
أنك تبحث عن كلمة مناسبة
أنك تؤكد على شيء ما
أنك تتوقف مؤقتاً قبل المتابعة
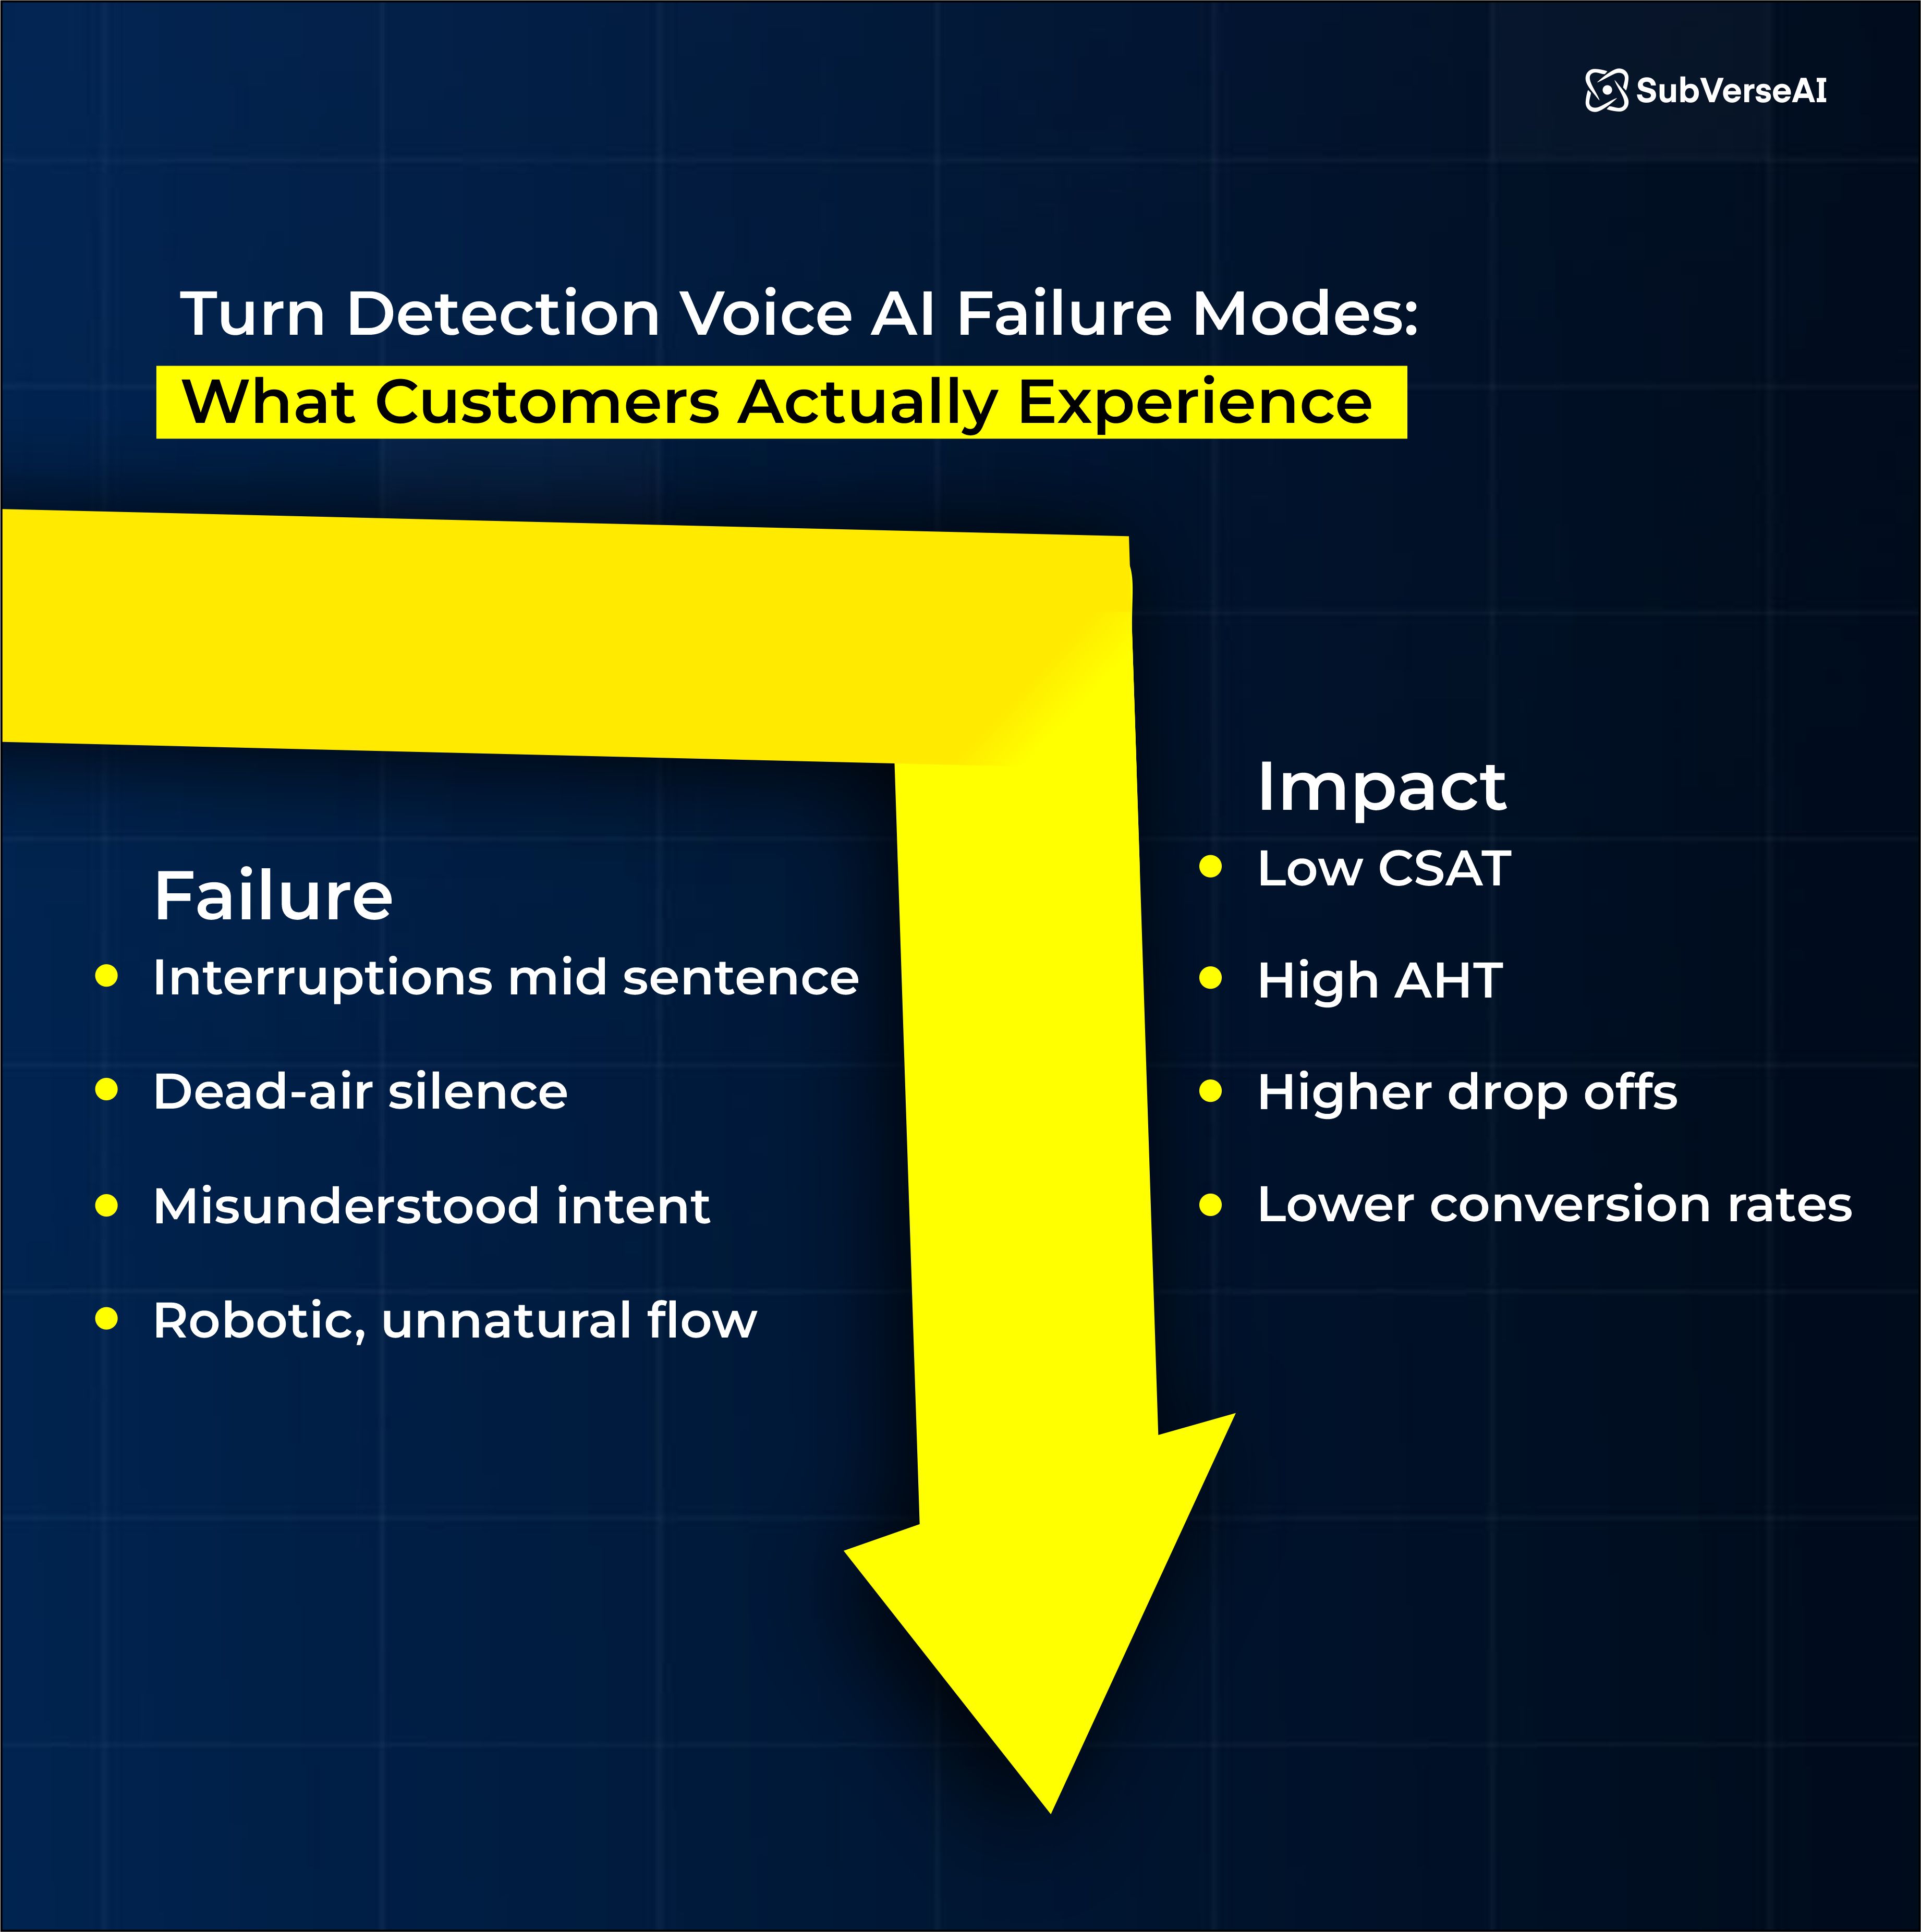
وهذا يؤدي إلى:
مقاطعات متكررة ومحبطة
لحظات صمت مطبق بطيئة ومزعجة بعد انتهائك من التحدث
سوء فهم لقصد المستخدم
تجربة آلية وغير طبيعية
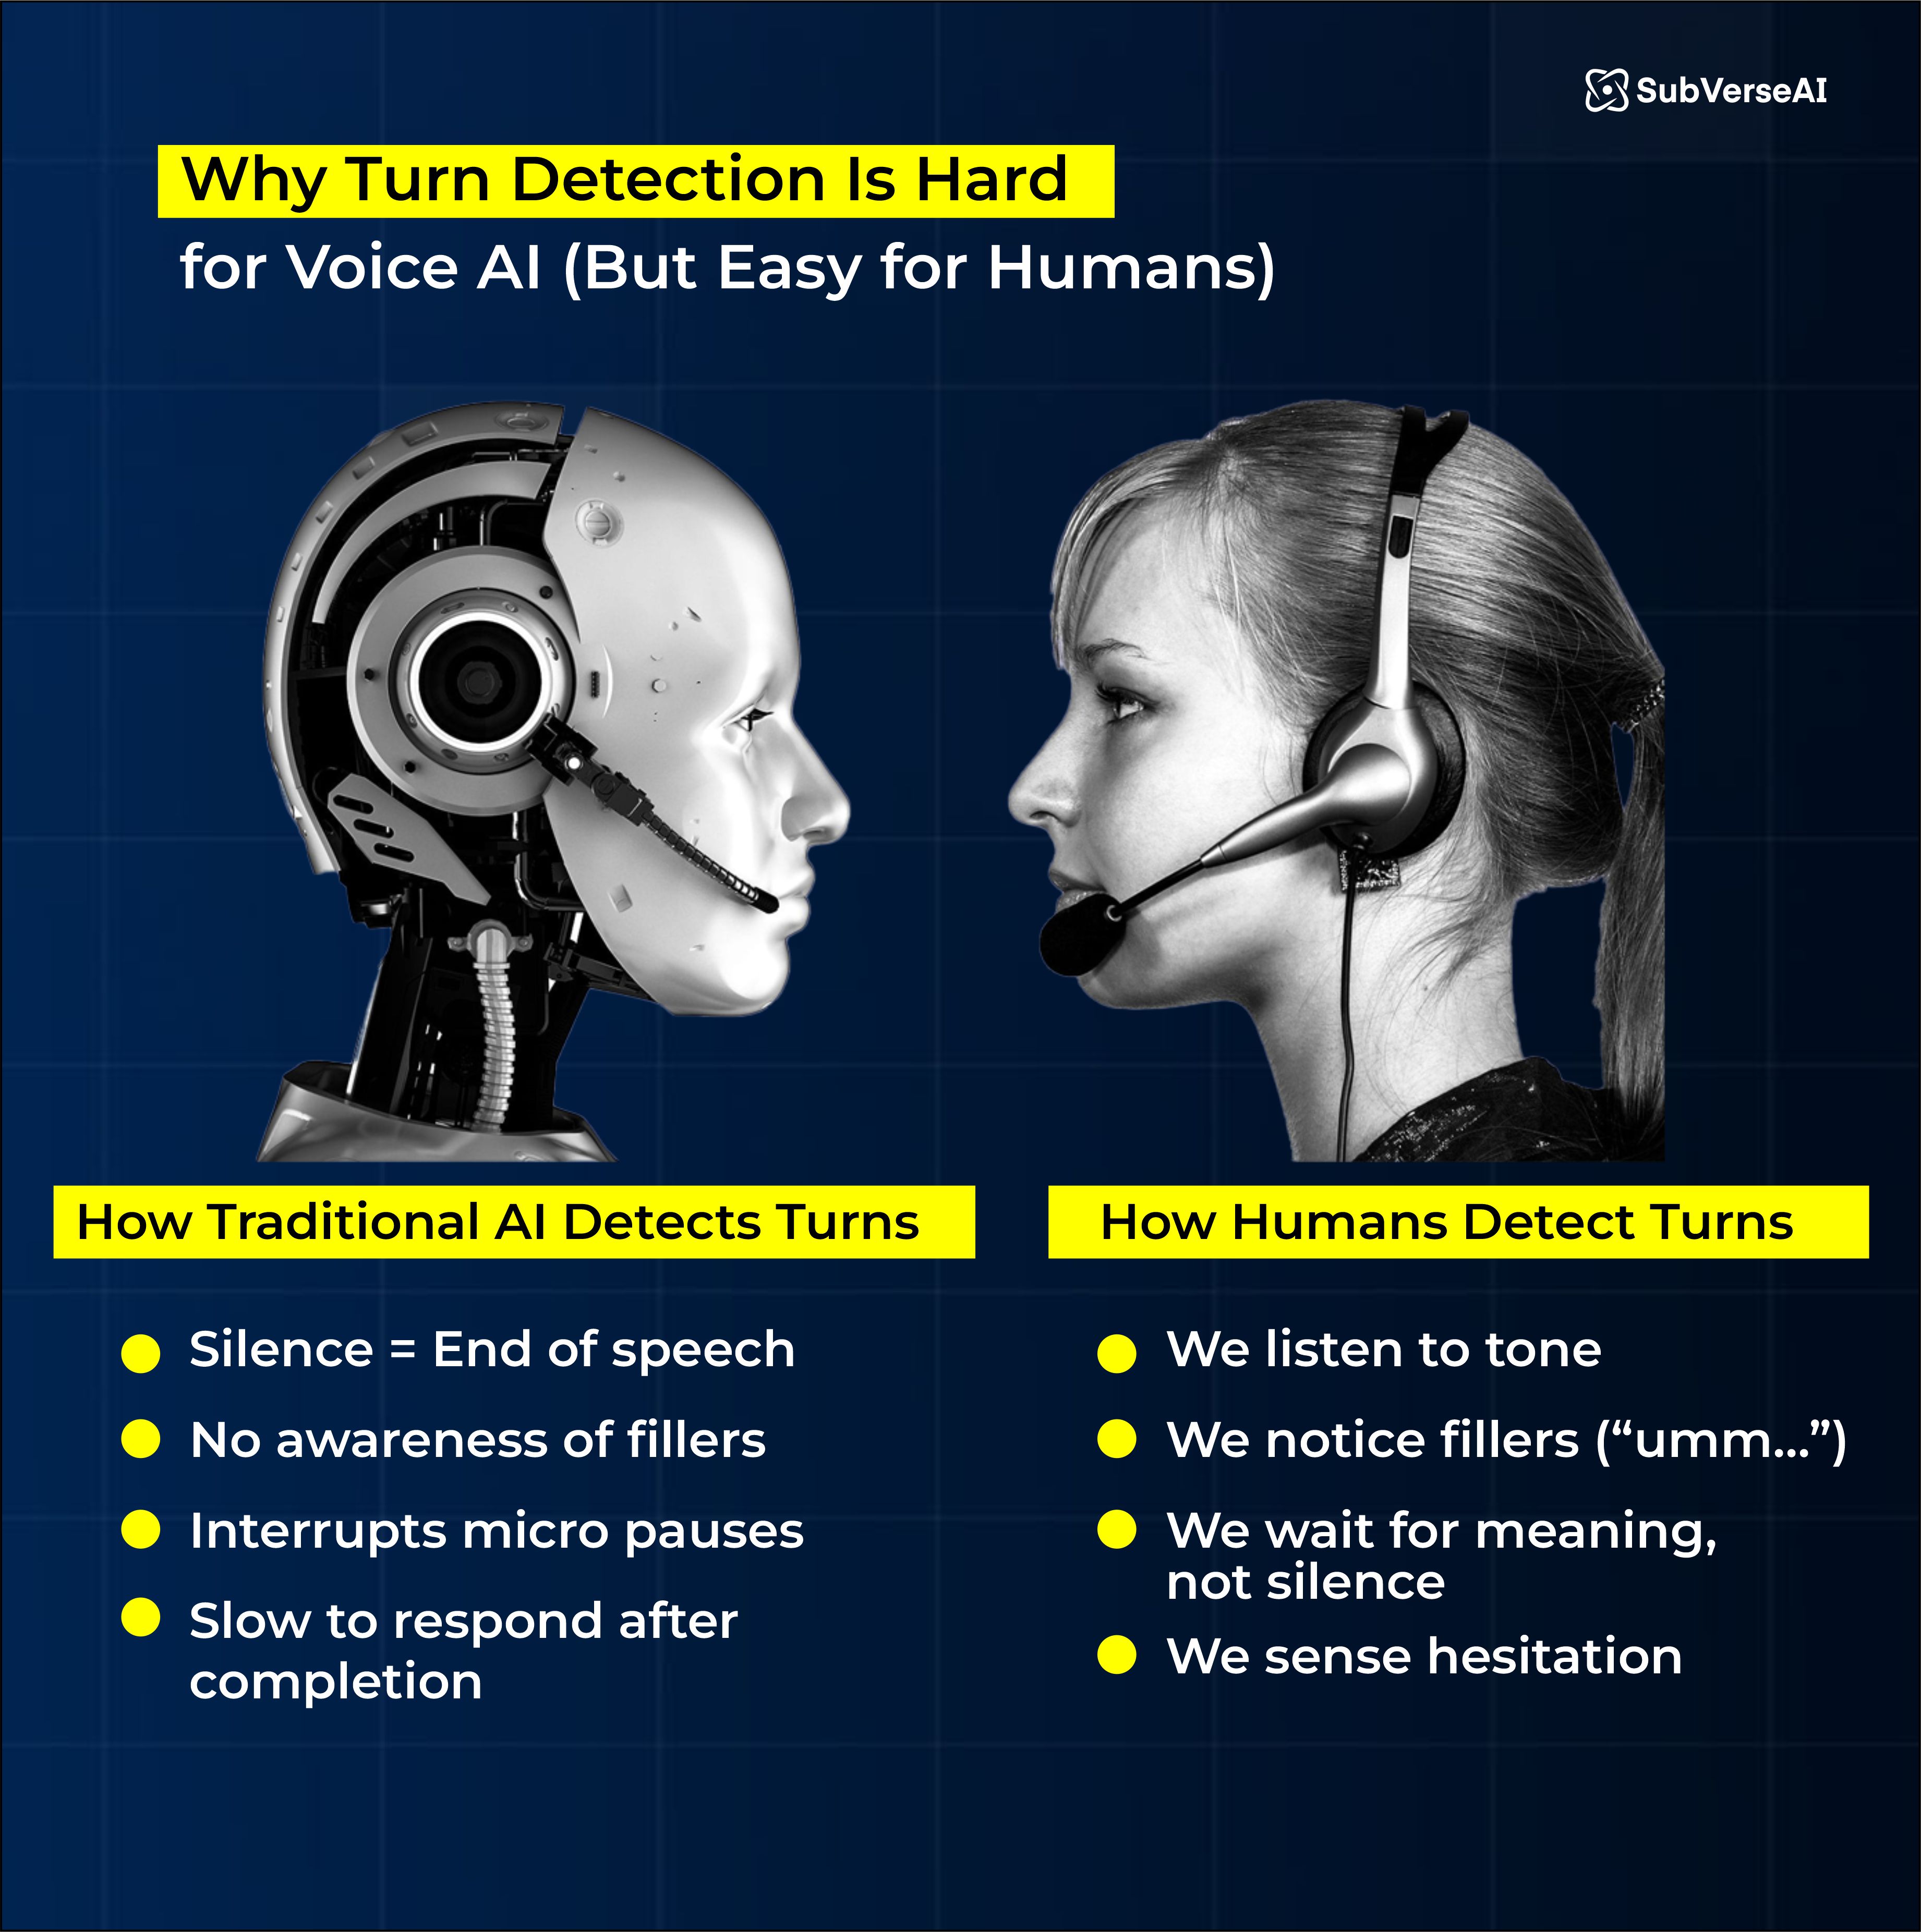
للمنافسة مع أفضل مزودي الذكاء الاصطناعي الصوتي عالمياً مع دعم الاتصالات، يجب أن يتجاوز النظام مجرد رصد الصمت ليفهم سلوك الكلام بشكل حقيقي.
ثلاثة أساليب حديثة لرصد تبادل الأدوار في الحديث
1. النماذج مفتوحة المصدر (المدركة للسياق والمتعددة اللغات)
تبحث أدوات اكتشاف تبادل الأدوار في الحديث مفتوحة المصدر - مثل ملحق أداة اكتشاف تبادل الأدوار من LiveKit أو Smart Turn Intelligence من Pipecat - في الإيقاع، وهيكل الجملة، والتنغيم الصوتي، وكلمات الحشو. وتتميز بأداء فائق في البيئات متعددة اللغات، بما في ذلك اللغات الهندية.
المزايا:
قابلة للتخصيص
تتسم بالشفافية وقابلة للاستضافة الذاتية
تعمل عبر مختلف اللهجات واللغات
مثالية لامتثال خصوصية المؤسسات
السلبيات:
تتطلب جهداً في الدمج والتكامل
تعتمد على جودة مجموعة البيانات
يُعد هذا خياراً مرناً للمنصات التي تعمل على مستوى عالمي ضمن بيئات اتصالات متنوعة.
2. اكتشاف النشاط الصوتي (VAD): سريع وخفيف الوزن
يراقب هذا النهج، الذي شاع استخدامه عبر نماذج مثل Silero VAD، شكل الموجة الصوتية للتمييز بين الكلام وغير الكلام ويطبق عتبات ذكية.
كيفية العمل:
اكتشاف متى يتحدث شخص ما بنشاط
تتبع التوقفات القصيرة للغاية (micro-pauses)
تشغيل الاستجابة بعد فترة صمت قابلة للتكوين
المزايا:
بسيط
زمن وصول منخفض للغاية
يعمل بكفاءة مع المكالمات الهاتفية المباشرة ومسارات الاستجابة الصوتية التفاعلية (IVR)
السلبيات:
يخفق عند التردد، أو مع اختلاف اللهجات، أو تداخل الكلام
غير مدرك للسياق
تعتمد العديد من أدوات أتمتة المكالمات القديمة على VAD فقط، ولهذا السبب غالباً ما تبدو "غير طبيعية".
3. اكتشاف تبادل الأدوار المدمج في تحويل الصوت إلى نص (ذكاء دلالي + صوتي)
هذا هو الاتجاه المستقبلي - حيث تقوم نماذج مثل Deepgram Flux بدمج تبادل الأدوار داخل محرك تحويل الصوت إلى نص.
يحلل Flux كلاً من الصوت والمعنى:
إذا قلت: "آممم... حسناً انتظر..." ← لم ينتهِ الكلام
إذا قلت: "هذا كل شيء، شكراً." ← تم الانتهاء
المزايا:
التجربة الأكثر طبيعية
زمن وصول منخفض للغاية (أسرع بمقدار 200-600 مللي ثانية)
مقاطعات أقل بكثير أثناء الحديث
ممتاز لوكلاء الصوت الموجهين للعملاء
السلبيات:
لا يزال قيد تعلّم أنماط الكلام الثقافية
يتطلب ضبطاً دقيقاً للاستخدام الخاص بكل مجال
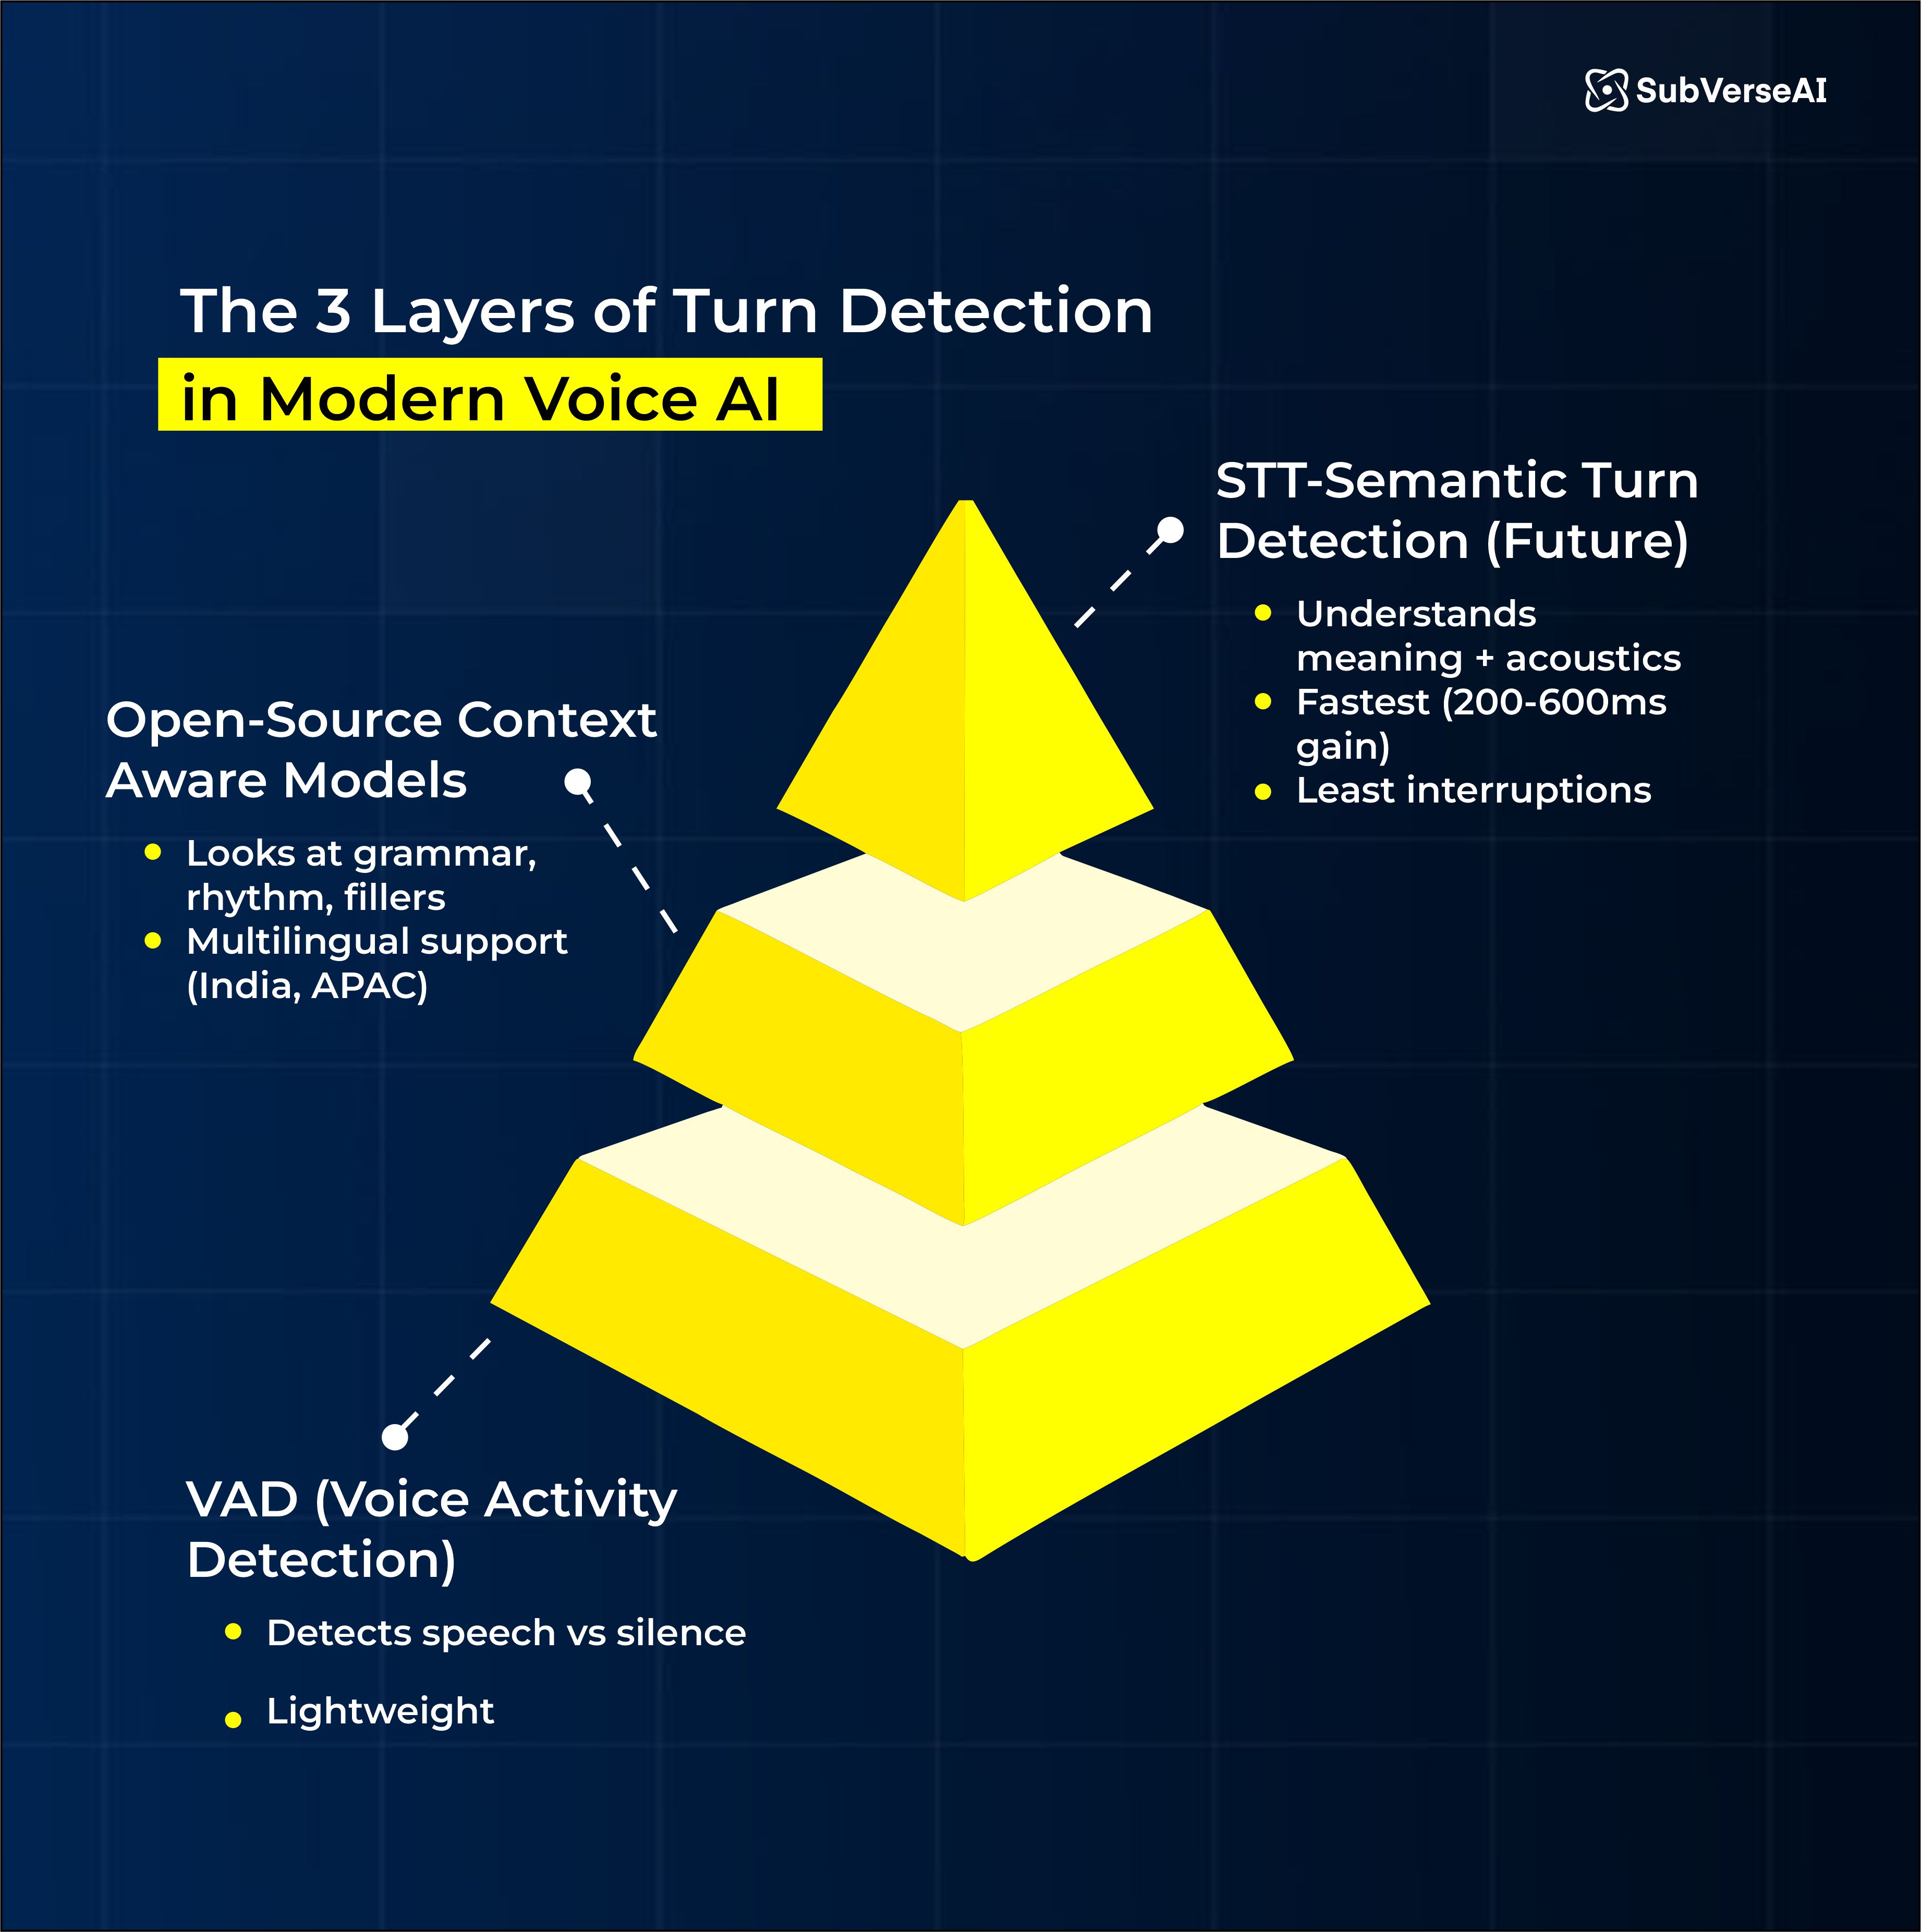
هذا هو النهج الذي يتبعه الرواد في هذا المجال - وهو النهج الذي تدمجه SubVerse لتوفير جودة محادثة فائقة المستوى.
النقطة المثالية: الجمع بين الثلاثة معاً
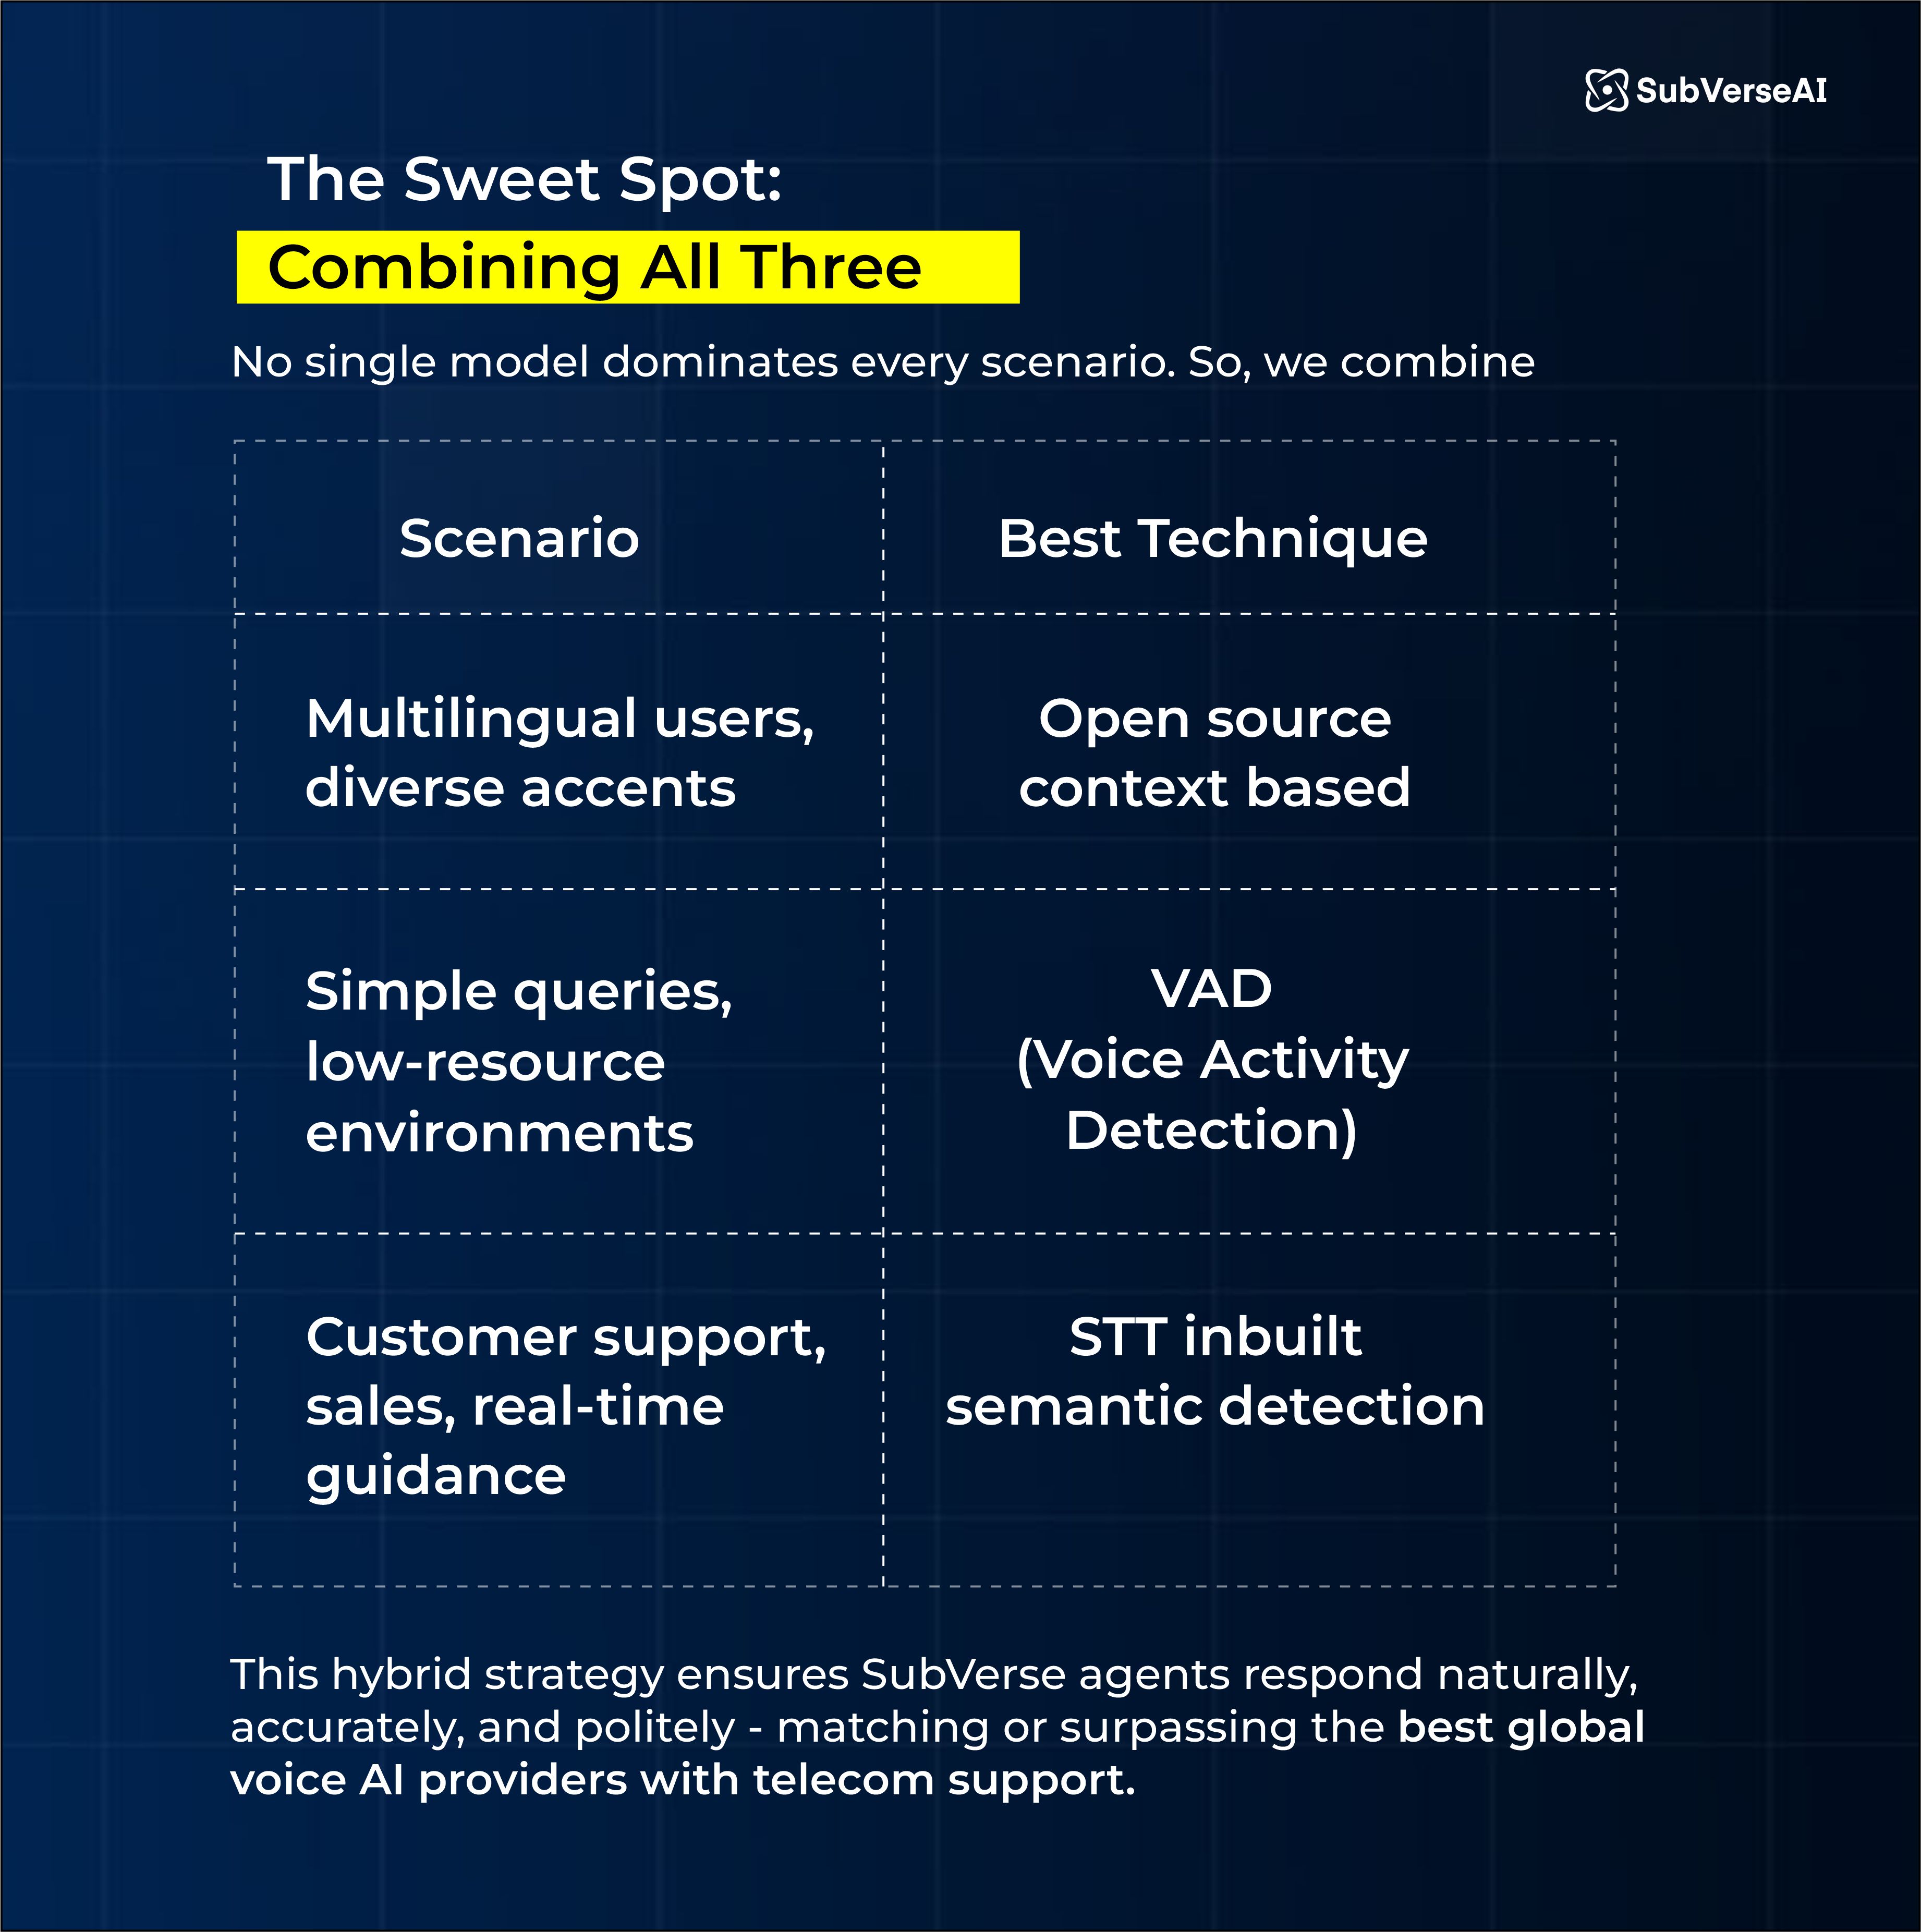
تضمن هذه الاستراتيجية الهجينة استجابة وكلاء SubVerse AI بشكل طبيعي ودقيق ومهذب - لتضاهي أو تتفوق على أفضل مزودي الذكاء الاصطناعي الصوتي عالمياً مع دعم الاتصالات.
أهمية هذا للشركات والمؤسسات
في قطاعات مثل الخدمات المصرفية والمالية والتأمين (BFSI)، أو التجارة الإلكترونية، أو التأمين، أو الرعاية الصحية، أو الضيافة، أو الخدمات اللوجستية، فإن الفارق بين محادثة سلسة وأخرى متعثرة يؤثر بشكل مباشر على:
رضا العملاء
معدلات حل المكالمات
متوسط وقت المعالجة (AHT)
معدلات التحويل
معدلات مغادرة العملاء للمكالمة
قد لا يبدو تحديد تبادل الأدوار في الحديث أمرًا مبهرًا، ولكنه قدرة حاسمة تفصل بين النجاح والفشل في تقنيات الذكاء الاصطناعي الصوتي الحديثة.
الطريق إلى الأمام: محادثات إنسانية بحق
يُعد تحديد تبادل الأدوار في الحديث جوهر التجربة الصوتية الطبيعية. فمن خلال الدمج بين الذكاء مفتوح المصدر، وتقنية اكتشاف النشاط الصوتي (VAD)، ونماذج تحويل الكلام إلى نص (STT) من الجيل القادم مثل Flux، فإننا نطور عملاء رقميين ينتظرون ويستمعون ويستجيبون بأسلوب بشري حقيقي.
وإذا كانت أنظمة الاستجابة الصوتية التفاعلية (IVR) غير العملية وروبوتات الدردشة التفاعلية المزعجة قد أثارت استياءك في الماضي، فإن المستقبل يبدو أكثر سلاسة - وأكثر لباقة بكثير.
المزيد من الرؤى والأفكار